
(2026年10月29日 追記:記事どおりに再現できるよう、必要なコードと手順を追加しました)
前回の第4回では、画像認識をFastAPIのAPIにしました。ただ、curl のようなコマンドは、現場の担当者には使えません。今回は、ブラウザで写真を選ぶだけで結果が見られる画面を作ります。
画面は、HTMLファイル1枚だけで作ります。専用のフレームワークは使いません。「画像認識の機能」と「画面」を分けておくと、画面だけを後から作り替えやすくなります。
この回で作るもの
- 写真を選び、しきい値をスライダーで変えて「認識する」を押す画面
- 認識結果の枠とラベルを、ブラウザ上で写真に重ねて表示する機能
- 種類ごとの個数を表にして表示する機能
- APIサーバーが、この画面を配る設定(
/にアクセスすると画面が開く)
仕組み:画面は「APIを呼び出して、結果を描く」だけ
[ブラウザ] 写真を選ぶ → /detect に送る
[API]      認識して、JSON(種類・信頼度・位置)を返す
[ブラウザ] 受け取ったJSONをもとに、写真の上に枠を描き、個数を表に出す第2回では、サーバー側(Python)で枠を描いた画像を作りました。今回は、ブラウザ側(JavaScript)で枠を描きます。サーバーは数字(JSON)を返すだけなので、画像を作り直す負荷がなく、写真の元データもそのまま残ります。
実装
APIサーバーから画面を配る
app/api.py に次の変更を加えます(+ が追加、- が削除)。
--- a/app/api.py
+++ b/app/api.py
@@ -7,14 +7,17 @@ from __future__ import annotations

 from collections.abc import AsyncIterator
 from contextlib import asynccontextmanager
+from pathlib import Path
 from typing import Annotated, Protocol

 from fastapi import FastAPI, File, HTTPException, Query, Request, UploadFile
+from fastapi.responses import FileResponse

 from app.config import DEFAULT_CONFIDENCE
 from app.detector import Detection, Detector
 from app.results import to_dict

+STATIC_DIR = Path(__file__).parent / "static"
 MAX_UPLOAD_BYTES = 10 * 1024 * 1024  # 10MB。これを超える画像は受け付けない


@@ -32,6 +35,10 @@ def create_app(detector: DetectorLike | None = None) -> FastAPI:

     app = FastAPI(title="果物の検品API", lifespan=lifespan)

+    @app.get("/", include_in_schema=False)
+    def index() -> FileResponse:
+        return FileResponse(STATIC_DIR / "index.html")
+
     @app.get("/health")
     def health() -> dict[str, str]:
         return {"status": "ok"}
/ にアクセスすると app/static/index.html が返ります。画面とAPIが同じサーバーにあるため、通信先の設定(CORSなど)が不要です。
画面 app/static/index.html
写真を送って結果を受け取る部分です。
// app/static/index.html(抜粋)
$("run").addEventListener("click", async () => {
  const file = $("file").files[0];
  $("message").textContent = "";
  if (!file) { $("message").textContent = "先に写真を選んでください。"; return; }
  const form = new FormData();
  form.append("file", file);
  $("run").disabled = true;
  try {
    const res = await fetch(`/detect?conf=${$("conf").value}`, { method: "POST", body: form });
    const body = await res.json();
    if (!res.ok) { throw new Error(typeof body.detail === "string" ? body.detail : "入力を確認してください。"); }
    await draw(file, body.detections);
    summarize(body.detections);
  } catch (err) {
    $("message").textContent = `認識できませんでした: ${err.message}`;
  } finally {
    $("run").disabled = false;
  }
});- 押している間はボタンを無効にする:連打して何度も送信されるのを防ぎます
- エラーは画面に文章で出す:写真を選んでいないときや、APIがエラーを返したときに、次にすることが分かる文言を表示します
写真の上に枠を描く部分です。
// app/static/index.html(抜粋)
async function draw(file, detections) {
  const bitmap = await createImageBitmap(file);
  const canvas = $("canvas");
  canvas.width = bitmap.width; canvas.height = bitmap.height;
  const ctx = canvas.getContext("2d");
  ctx.drawImage(bitmap, 0, 0);
  for (const d of detections) {
    const [l, t, r, b] = d.box;
    ctx.strokeStyle = ctx.fillStyle = colorFor(d.label);
    ctx.strokeRect(l, t, r - l, b - t);
    ...
  }
}canvas(ブラウザ上のお絵かきの領域)に、選んだ写真をそのまま描き、その上に枠とラベルを重ねます。結果の表を作るときは、textContent で文字を入れています。innerHTML を使わないのは、APIの結果に予期しない文字が混ざっても、それがHTMLとして実行されないようにするためです。
画面のファイルの全体は次のとおりです。app/static フォルダを作り(mkdir app/static)、その中に index.html として保存します。上の2つの抜粋も、このファイルの一部です。
app/static/index.html の全文(100行)
<!-- app/static/index.html -->
<!doctype html>
<html lang="ja">
<head>
<meta charset="utf-8">
<meta name="viewport" content="width=device-width, initial-scale=1">
<title>果物の検品ツール</title>
<style>
  body { font-family: sans-serif; margin: 0; padding: 16px; color: #1f2933; background: #f7f8fa; }
  main { max-width: 760px; margin: 0 auto; }
  h1 { font-size: 1.3rem; }
  .row { display: flex; gap: 12px; align-items: center; flex-wrap: wrap; margin: 12px 0; }
  button { padding: 8px 16px; font-size: 1rem; cursor: pointer; }
  canvas { max-width: 100%; height: auto; border: 1px solid #ccd; background: #fff; }
  table { border-collapse: collapse; margin-top: 12px; }
  td, th { border: 1px solid #ccd; padding: 4px 10px; text-align: left; }
  #message { color: #b42318; min-height: 1.4em; }
</style>
</head>
<body>
<main>
  <h1>果物の検品ツール</h1>
  <p>写真を選んで「認識する」を押すと、見つかった物体に枠を付けて表示します。</p>
  <div class="row">
    <input type="file" id="file" accept="image/*">
    <label>しきい値 <input type="range" id="conf" min="0.05" max="0.95" step="0.05" value="0.25">
      <output id="confValue">0.25</output></label>
    <button id="run" type="button">認識する</button>
  </div>
  <p id="message" role="alert"></p>
  <canvas id="canvas" width="1" height="1" aria-label="認識結果の画像"></canvas>
  <table id="summary" hidden>
    <thead><tr><th>種類</th><th>個数</th></tr></thead>
    <tbody></tbody>
  </table>
</main>
<script>
const $ = (id) => document.getElementById(id);
const COLORS = ["#e63946", "#1d78dc", "#2a9d8f", "#f4a261", "#8338ec", "#06d6a0"];
const colorFor = (label) => COLORS[[...new TextEncoder().encode(label)].reduce((a, b) => a + b, 0) % COLORS.length];

$("conf").addEventListener("input", () => { $("confValue").textContent = $("conf").value; });

$("run").addEventListener("click", async () => {
  const file = $("file").files[0];
  $("message").textContent = "";
  if (!file) { $("message").textContent = "先に写真を選んでください。"; return; }
  const form = new FormData();
  form.append("file", file);
  $("run").disabled = true;
  try {
    const res = await fetch(`/detect?conf=${$("conf").value}`, { method: "POST", body: form });
    const body = await res.json();
    if (!res.ok) { throw new Error(typeof body.detail === "string" ? body.detail : "入力を確認してください。"); }
    await draw(file, body.detections);
    summarize(body.detections);
  } catch (err) {
    $("message").textContent = `認識できませんでした: ${err.message}`;
  } finally {
    $("run").disabled = false;
  }
});

async function draw(file, detections) {
  const bitmap = await createImageBitmap(file);
  const canvas = $("canvas");
  canvas.width = bitmap.width; canvas.height = bitmap.height;
  const ctx = canvas.getContext("2d");
  ctx.drawImage(bitmap, 0, 0);
  ctx.lineWidth = Math.max(2, bitmap.width / 200);
  ctx.font = `${Math.max(12, bitmap.width / 40)}px sans-serif`;
  for (const d of detections) {
    const [l, t, r, b] = d.box;
    ctx.strokeStyle = ctx.fillStyle = colorFor(d.label);
    ctx.strokeRect(l, t, r - l, b - t);
    const text = `${d.label} ${d.confidence.toFixed(2)}`;
    const w = ctx.measureText(text).width + 6, h = parseInt(ctx.font, 10) + 6;
    ctx.fillRect(l, Math.max(0, t - h), w, h);
    ctx.fillStyle = "#fff";
    ctx.fillText(text, l + 3, Math.max(h - 5, t - 5));
  }
}

function summarize(detections) {
  const counts = {};
  for (const d of detections) counts[d.label] = (counts[d.label] || 0) + 1;
  const body = $("summary").querySelector("tbody");
  body.replaceChildren();
  for (const [label, n] of Object.entries(counts)) {
    const tr = document.createElement("tr");
    for (const text of [label, String(n)]) {
      const td = document.createElement("td"); td.textContent = text; tr.appendChild(td);
    }
    body.appendChild(tr);
  }
  $("summary").hidden = detections.length === 0;
  if (detections.length === 0) $("message").textContent = "何も見つかりませんでした。しきい値を下げると見つかる場合があります。";
}
</script>
</body>
</html>
動かして確かめる
uvicorn app.api:app --port 8000
# ブラウザで http://127.0.0.1:8000/ を開き、samples/fruits.jpg を選んで「認識する」
開発環境(Linux上のChromium)で操作した画面が次のとおりです。ブラウザやOSにより、見た目は異なります。
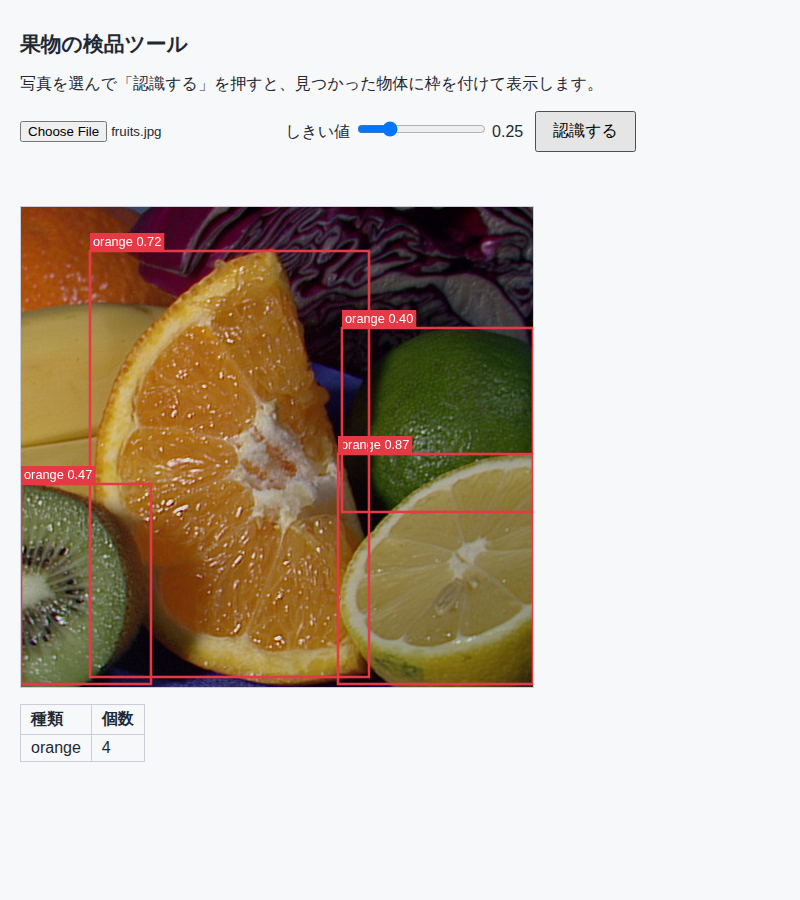
- 写真の上に、第2回と同じ枠とラベルが表示されました
- 下の表に「orange 4」と個数が出ています
- 写真を選ばずに押すと「先に写真を選んでください。」と表示されました
- 前回に続き、レモンやキウイを「orange」と答えている点は変わりません。画面にすると、この問題が現場の人にも一目で伝わります
テスト
画面が配られることを確かめるテストを、tests/test_api.py の最後に足します。次の変更を加えます(+ が追加、- が削除)。
--- a/tests/test_api.py
+++ b/tests/test_api.py
@@ -53,3 +53,10 @@ def test_too_large_is_413(monkeypatch) -> None:  # type: ignore[no-untyped-def]
     with _client(_FakeDetector()) as client:
         res = client.post("/detect", files={"file": ("a.jpg", b"x" * 11, "image/jpeg")})
     assert res.status_code == 413
+
+
+def test_index_page_is_served() -> None:
+    with _client(_FakeDetector()) as client:
+        res = client.get("/")
+    assert res.status_code == 200
+    assert "果物の検品ツール" in res.text
pytest -q # 21件成功
ruff check . # 問題なし画面が配られることは、自動テストで確認しています。ボタンの操作や描画は、この回では自動テストではなく、実際のブラウザ(Chromium)を操作して確認しました。
つまずきやすい点
- 大きな写真が横にはみ出す:
canvasの最大幅を画面幅に合わせています(max-width: 100%) - スマホで撮った写真の向き:写真の向き情報(EXIF)の扱いで、横向き・縦向きが変わって見える場合があります。実際の端末で確認が必要です
- 認証がない:前回と同じく、この画面には認証がありません。社内ネットワークの外に公開する前に、認証を付けます
- 画面の作り込みは別:この画面は最小限です。ログイン、履歴、権限管理などは、要件が増えると費用が大きく変わります
発注者向けメモ:画面の範囲を先に決める
画像認識のシステムでは、AIの部分に注目が集まりがちですが、現場で使われるかどうかは画面の使いやすさで決まることが多くあります。一方で、画面の作り込みは費用が大きく変わる部分でもあります。
発注者がやること チェックリスト
- ☐ 誰が・どの端末(PC・スマホ・タブレット)で使うかを決めた
- ☐ 写真をどう入れるか(ファイル選択・カメラ撮影・フォルダ監視)を決めた
- ☐ 結果画面に必要な情報(枠・個数・履歴・修正機能)を、優先順位をつけて書き出した
- ☐ ログインや権限(誰が何を見られるか)が必要かを決めた
開発会社への質問例
- 「画面は、どの端末・ブラウザまで動作確認の対象ですか」
- 「最初のリリースに含める画面と、後から追加する画面は、どう分けますか」
- 「ログインや、利用者ごとの権限は、見積もりに含まれていますか」
- 「画面の変更(項目追加など)は、どの範囲まで保守に含まれますか」
まとめと次回予告
第5回では、次のことを行いました。
- ブラウザで写真を選び、認識結果を写真の上に表示する画面を作った
- 種類ごとの個数を、表で見られるようにした
- APIサーバーが画面も配るようにした
- 画面の操作を、実際のブラウザで確認した
次回の第6回では、ここまで「見た目で」確認してきた精度を、数字で測る方法(正解ラベルと、適合率・再現率)に進みます。
この連載の記事一覧
この記事は連載「YOLOで作る画像認識ツール」の1回です。連載のほかの回は次のとおりです(連載の一覧ページ)。
- 【YOLOで作る画像認識ツール 第0回】全体像と環境づくり:YOLOで最初の1枚を認識する
- 【YOLOで作る画像認識ツール 第1回】信頼度のしきい値とJSON出力:認識結果を「使える形」にする
- 【YOLOで作る画像認識ツール 第2回】認識結果を画像に描いて確認する:枠とラベルで「間違い」を見つけやすくする
- 【YOLOで作る画像認識ツール 第3回】種類ごとに何個あるか数えて、CSVに集計する
- 【YOLOで作る画像認識ツール 第4回】FastAPIで画像認識を「API」にして、ほかのシステムから使えるようにする
- 【YOLOで作る画像認識ツール 第5回】ブラウザから写真をアップロードして、認識結果をその場で見る(この記事)
- 【YOLOで作る画像認識ツール 第6回】精度を数字で測る:正解データと、適合率・再現率
- 【YOLOで作る画像認識ツール 第7回】学習済みモデルにない対象を覚えさせる:追加学習の手順と、結果の正しい読み方
- 【YOLOで作る画像認識ツール 第8回】自信の低い結果だけ人が確認する:AIと人の役割分担を設計する
- 【YOLOで作る画像認識ツール 第9回】速く・軽くする:ONNXに変換してCPUで動かし、変換前後を比べる
- 【YOLOで作る画像認識ツール 第10回】Dockerで動かす:設定・ログ・ヘルスチェックを運用に近い形にする
- 【YOLOで作る画像認識ツール 第11回(最終回)】運用の注意点とライセンス(AGPL-3.0):精度の低下に気づく仕組みと、連載のまとめ








