
(2026年10月29日 追記:記事どおりに再現できるよう、必要なコードと手順を追加しました)
前回(第8回)では、部屋名とExcelの欄の対応付けを設定ファイル(YAML)に移し、様式の違うテンプレートにもコードを変えずに転記できるようにしました。
第9回は、フォルダに入った複数の図面PDFをまとめて処理する一括処理をPythonで作ります。ポイントは次の3つです。
- 「1件ずつ確認」か「まとめて流して結果一覧で確認」かを先に決める。今回は後者で、問題が見つかったPDFは「要確認」として転記しない
- 1件が壊れていてもそのPDFを「失敗」にして次へ進む。ログには図面の中身を書かない
- 重い処理は別スレッドで動かし、画面の更新はメインスレッドだけで行う。処理中も画面が固まらず、進捗表示と「中止」ができる
今回作る機能と完成イメージ
メイン画面に「7. フォルダ内のPDFをまとめて処理する」ボタンを追加します。
- フォルダ直下のPDFを名前順に1件ずつ処理し、「成功(転記済み)」「要確認」「失敗」と理由を一覧に出す
- 進捗バーで何件目か分かり、「中止」で残りを止められる
- PDFのフォルダの中に
転記結果_<日時>を作り、Excelとログを保存する - 「要確認」「失敗」の行をダブルクリックすると、そのPDFをメイン画面に読み込み、「4.」→「5.」→「6.」で1件ずつ処理できる
第5回から残っていた「外部AIの通信中に画面が固まる」問題も、同じ仕組みで解消します。
仕組みの説明:一括処理の運用は2通りある
「1件ずつ確認」と「まとめて流して結果一覧で確認」
| 運用 | 流れ | 向いている場面 | 作るときの負担 |
|---|---|---|---|
| A. 1件ずつ確認画面を挟む | 読むたびに確認画面を開き、確定後に転記 | 件数が少ない・誤転記の影響が大きい | 処理を止めて人を待つ仕組みと、複数ページの確認画面 |
| B. まとめて流して結果一覧で確認 | 問題の無いものは自動で転記し、残りを「要確認」で残す | 件数が多い・埋め込み文字の図面が中心 | 「要確認」の判定ルールと結果一覧 |
今回はBを実装し、「要確認」のPDFはAと同じ1件ずつの流れ(第6回の確認画面。1ページ単位)へ引き継ぎます。ただし、Bの「成功」は人が確認する前に転記されたもので、第6回からの「人が確認してから転記する」方針を「転記後に結果一覧と出力Excelで確認する」運用に置き換えることになります。
「要確認」にする条件
| 条件 | 理由 |
|---|---|
| 部屋名候補が0件 | 文字が無い・辞書に無い表記の可能性 |
| OCRで読んだページがある(既定) | 読み取り漏れは信頼度に表れない |
| OCRの信頼度が80未満の部屋名がある | 誤読の可能性 |
| 同じ部屋名が複数ある | 1階と2階のトイレか二重検出かは人が判断 |
| 欄に収まらない・欄の無い部屋名がある | 第8回の設定で書き込めない |
| 30ページを超えた | 先頭30ページしか読んでいない |
しきい値80は架空の図面で決めた暫定値です。150dpi相当のスキャンでは部屋名の信頼度が91〜96、72dpi相当では75・76が出ました。72dpi相当では「バルコニー」が読めず候補から消えていました。読めなかった部屋名は低信頼度の候補としても残らないため、OCRで読んだPDFは既定で常に要確認です(画面のチェックで外せます)。
画面が固まる理由と、別スレッドへの分け方
tkinterは、クリックも再描画も1つのスレッド(メインスレッド)で順番に処理します。ボタンの処理の中で通信やOCRを待つと、その間は再描画も「中止」も受け付けません。公式ドキュメントでも、時間のかかる処理はイベントハンドラーの中で行わず、小分けにするか別スレッドで動かすよう説明されています。
📰 出典:Python公式ドキュメント tkinter「Threading model」
そこで、OCR・外部AIとの通信・一括処理全体は別スレッド(ワーカースレッド)で動かし、画面の更新はメインスレッドだけで行います。両者は queue.Queue(スレッド間で安全に受け渡せる待ち行列)でつなぎ、メインスレッドは after()(一定時間後に関数を呼ぶ仕組み)で定期的にキューを見ます。同じドキュメントには別スレッドからのtkinter呼び出しが失敗する条件も書かれています。
もう1つの注意点はPyMuPDFです。公式ドキュメントに「複数のスレッドで動かすことはサポートしていない」と明記されています。
📰 出典:PyMuPDF公式ドキュメント「Multiprocessing」
そこで、PyMuPDFを呼ぶ区間をすべて1つのロック(同時に1つのスレッドしか入れない仕組み)で囲み、一括処理の画面を開いている間はメイン画面を操作できないようにしました。単票の読み取りでは画像化をメインスレッドで済ませ、別スレッドには画像だけを渡します。公式が勧める別プロセス(multiprocessing)は、exe化(第11回)との相性も含め扱いが重くなるため採用していません。
実装
ファイル構成(第9回時点の差分)
app/
├ core/
│  ├ batch.py          … 新規:フォルダ内のPDFを1件ずつ読み取り・判定・転記、結果一覧とログ
│  ├ background.py     … 新規:重い処理を別スレッドで動かし、結果をメインスレッドへ渡す
│  ├ pdf_loader.py     … 変更:PyMuPDFを呼ぶ区間をロック(PDF_LOCK)で囲む
│  ├ text_extractor.py … 変更:文字の取り出しもロックの内側で。ExtractedWordに信頼度を追加
│  ├ ocr_local.py      … 変更:画像化済みのページをOCRする ocr_rendered_page() を切り出し
│  └ ocr_ai.py         … 変更:画像化済みのページを送る ai_ocr_rendered_page() を切り出し
└ ui/
   ├ batch_dialog.py   … 新規:一括処理の画面(フォルダ選択・開始/中止・進捗バー・結果一覧)
   └ main_window.py    … 変更:「7.」ボタン、単票の読み取りを別スレッドへ、進捗表示と「中止」
tests/
├ test_batch.py        … 新規22件
├ test_background.py   … 新規6件
└ test_ocr_local.py    … 変更:OCRの信頼度と ocr_rendered_page() のテスト(1件追加)
tools/
└ make_sample_pdf.py   … 変更:--batch で一括処理の確認用フォルダ(壊れたファイルを含む)を作る
.gitignore … 変更:一括処理の出力フォルダ・ログを追跡しない新しいパッケージは追加していません(threading・queue はPythonの標準ライブラリです)。
フォルダ内のPDFを列挙する(app/core/batch.py)
フォルダ直下のPDFを名前順に並べます。一時ファイル(~$ で始まる)や隠しファイルは除きます。
# app/core/batch.py(抜粋)
def list_pdf_files(folder: str | Path) -> list[Path]:
    directory = Path(folder)
    if not directory.is_dir():
        raise BatchError(f"フォルダが見つかりません: {directory}")
    files = [
        path
        for path in directory.iterdir()
        if path.is_file() and path.suffix.lower() == ".pdf" and not path.name.startswith(("~$", "."))
    ]
    return sorted(files, key=lambda p: unicodedata.normalize("NFKC", p.name).casefold())
1件分の処理:例外は「失敗」にして次へ進む
process_pdf() は1件の読み取り(全ページ。埋め込み文字が無いページだけOCR)→判定→転記を行います。どんな例外もこの中で受け止めて「失敗」として返すので、呼び出し側の繰り返しは止まりません。
# app/core/batch.py(抜粋)
    try:
        page_count, candidates, sources, reasons = _read_pdf(path, dictionary, options, ocr_func, cancel_event)
        review = ReviewList.from_candidates(
            candidates, source=SOURCE_OCR if SOURCE_OCR in sources else SOURCE_EMBEDDED, dictionary=dictionary
        )
        rooms = tuple(item.name for item in review.items)
        reasons += _judge(candidates, review, sources, options)
        # (中略:第8回の plan_cells() で欄に収まるかを確かめ、収まらなければ reasons に追加)

        common = {"page_count": page_count, "sources": tuple(sources), "rooms": rooms}
        if reasons:
            return result(STATUS_REVIEW, reasons, **common)
        # (中略:問題が無ければ第7回の write_rooms_to_excel() で転記)
        return result(STATUS_SUCCESS, [], output_path=written.output_path, **common)
    except _Cancelled:
        return result(STATUS_CANCELLED, [Reason(REASON_CANCELLED, "中止したため処理していません")], page_count=page_count)
    except PdfLoadError as exc:
        return result(STATUS_FAILED, [Reason(REASON_PDF_OPEN, str(exc))], page_count=page_count)
    except OcrError as exc:
        return result(STATUS_FAILED, [Reason(REASON_OCR_ERROR, str(exc))], page_count=page_count)
    # (中略:Excelの記入欄に値がある・書き込みエラーも同様に「失敗」)
    except Exception as exc:  # 想定外のエラーでも、このPDFを「失敗」にして次へ進む
        message = f"想定外のエラー({type(exc).__name__}):{exc}"
        return result(
            STATUS_FAILED, [Reason(f"{REASON_UNEXPECTED}:{type(exc).__name__}", message)], page_count=page_count
        )
二重検出の統合は第6回、欄の割り当ては第8回、書き込みは第7回の処理をそのまま使っています。
出力ファイル名がぶつからないようにする
出力は <PDF名>_転記.xlsx です。Windowsは大文字小文字を区別しないため、plan.pdf と PLAN.pdf は同じ名前になります。使った名前を大文字小文字・全角半角をそろえて記録し、既存のファイルも含めてぶつかったら _2 を付けます。出力フォルダも同様に前回分を上書きしません。
# app/core/batch.py(抜粋)
def unique_output_path(output_dir: Path, pdf_path: Path, suffix: str, reserved: set[str]) -> Path:
    base = f"{pdf_path.stem}_{OUTPUT_FILE_LABEL}"
    counter = 1
    while True:
        name = f"{base}{suffix}" if counter == 1 else f"{base}_{counter}{suffix}"
        key = unicodedata.normalize("NFKC", name).casefold()
        if key not in reserved and not (output_dir / name).exists():
            reserved.add(key)
            return output_dir / name
        counter += 1
ログには「何が起きたか」だけを書く
ログ(batch_log.txt)には日時・ファイル名・結果・ページ数・方式・候補の件数・処理時間・理由の種類だけを書き、部屋名、例外のメッセージ本文、APIキーは書きません。ログは共有フォルダに置かれたり、問い合わせで社外に送られたりしやすいためです。理由は画面用の文章とログ用の種類(件数だけ)を分けて持たせています。
# batch_log.txt の例(日時は記事の想定日に置き換えています)
[2026-02-17 10:00:00] 4/8 サンプルD邸_粗いスキャン.pdf 結果=要確認 ページ=2 方式=ocr 候補=6件 時間=0.43秒 理由=low_confidence(2),ocr_used
[2026-02-17 10:00:00] 8/8 サンプルH邸_壊れたファイル.pdf 結果=失敗 ページ=0 方式=- 候補=0件 時間=0.00秒 理由=pdf_open重い処理を別スレッドで動かす(app/core/background.py)
BackgroundJob は関数を別スレッドで実行し、途中経過・結果・例外をキューに入れます。メインスレッドは after() で定期的に取り出してコールバックを呼びます。after に当たる関数を引数で受け取るので、pytestでは偽のイベントループで検証できます。
# app/core/background.py(抜粋)
    def start(self) -> None:
        if self._thread is not None:
            raise RuntimeError("この処理はすでに開始しています。")
        # daemon=True:処理の途中でウィンドウを閉じても、アプリの終了を妨げないようにする
        self._thread = threading.Thread(target=self._run, name="madori-ocr-worker", daemon=True)
        self._thread.start()
        self._schedule(self._poll_ms, self._poll)

    def post(self, message: Any) -> None:
        """ワーカースレッドから途中経過を送る(画面は触らず、キューに入れるだけ)。"""
        self._queue.put((_KIND_MESSAGE, message))

    def _run(self) -> None:
        try:
            result = self._work(self)
        except BaseException as exc:  # どんな例外でも画面側へ渡し、スレッドの中で握りつぶさない
            self._queue.put((_KIND_ERROR, exc))
        else:
            self._queue.put((_KIND_DONE, result))

    def _poll(self) -> None:
        """メインスレッドで呼ばれ、キューにたまったものを順に取り出してコールバックへ渡す。"""
        while True:
            try:
                kind, payload = self._queue.get_nowait()
            except queue.Empty:
                break
            if kind == _KIND_MESSAGE:
                if self._on_message is not None:
                    self._on_message(payload)
                continue
            self._finished = True
            if kind == _KIND_DONE:
                self._on_done(payload)
            else:
                self._on_error(payload)
            return  # 完了したので、これ以上キューを見に行かない
        self._schedule(self._poll_ms, self._poll)
「中止」は threading.Event に合図を立てるだけです。スレッドは外から安全に止められないため、ページの区切りと次のPDFの前で合図を確認し、残りを「未処理」にします。
一括処理の画面(app/ui/batch_dialog.py)
「開始」で run_batch() を別スレッドで呼びます。途中経過は job.post でキューに入れるだけで、進捗バーと一覧はメインスレッドの _on_progress() で更新します。
# app/ui/batch_dialog.py(抜粋)
        def work(job: BackgroundJob) -> BatchSummary:
            # ここは別スレッドで動く。画面(ウィジェット)には触らず、途中経過は job.post で送る
            return run_batch(
                pdfs,
                template=self._template,
                mapping=self._mapping,
                dictionary=self._dictionary,
                output_dir=output_dir,
                options=options,
                on_progress=job.post,
                cancel_event=job.cancel_event,
            )

        self._job = BackgroundJob(
            work, schedule=self.after, on_done=self._on_done, on_error=self._on_error, on_message=self._on_progress
        )
self._job.start()単票の外部AI・OCRも別スレッドへ(app/ui/main_window.py)
「3.」「4.」ボタンの読み取りも同じ仕組みに載せました。画像化はメインスレッドで済ませ、OCR・外部AIだけを別スレッドに任せるため、「画像化済みのページを受け取る」関数(ocr_rendered_page()・ai_ocr_rendered_page())を切り出しています。
# app/ui/main_window.py(抜粋。外部AIの場合)
        try:
            rendered = document.render_page(page_number, zoom=1.0)  # PyMuPDFはこのスレッドで
        except PdfLoadError as exc:
            messagebox.showerror("外部AIエラー", str(exc))
            return
        client = self._create_ai_client(api_key)
        self._run_in_background(
            lambda _job: ai_ocr_rendered_page(rendered, client=client, model=model).words,
            message="外部AIで読み取っています(通信中)...「中止」で結果を捨てられます",
            on_done=lambda words: self._deliver_detection(document, page_number, words, "ai", on_detected),
            error_title="外部AIエラー",
        )
処理中はボタンを押せなくし、進捗バーを動かします。読み取り中にページやPDFを切り替えた場合と「中止」を押した場合は、戻ってきた結果を捨てます(送信済みなら外部AIの料金はかかる旨も表示)。
この回で追加・変更するファイル
新しいパッケージはありません(threading・queue はPythonの標準ライブラリです)。まず、新しく作る3つのファイルの全体です。
app/core/batch.py を新しく作ります(全文)。
app/core/batch.py の全文(572行)
# app/core/batch.py
"""フォルダ内の複数の図面PDFを、まとめて読み取り・判定・Excel転記するコア処理(第9回)。

第8回までは「1つのPDFの表示中の1ページ」を読み取り、確認画面で確定してから
Excelへ転記していた。この回は、フォルダを指定して中のPDFを1件ずつ順に処理する。

    フォルダ内のPDFを列挙(list_pdf_files)
      └ 1件ずつ(process_pdf)
          1. PDFを開き、全ページの文字を読む(埋め込み文字 → 無ければローカルOCR)
          2. 部屋名辞書で候補を絞り込む(第3回)・二重検出をまとめる(第6回)
          3. 判定:問題が見つからなければ「成功」、人が見るべき点があれば「要確認」
          4. 「成功」だけ、テンプレートに合わせた欄へ転記して別名で保存(第7・8回)
          5. 例外が起きたら「失敗」として理由を残し、次のPDFへ進む
      └ 結果の一覧(BatchSummary)とログファイル

運用の選択肢は2つある(記事で比較する)。

- A. 1件ずつ確認画面を挟む:読み取るたびに第6回の確認画面を開き、人が確定してから転記
- B. まとめて流して結果一覧で確認:機械的に判定できる問題(候補0件・OCRの信頼度が低い・
  同名の重複・欄に収まらない等)が無いものだけ転記し、残りは「要確認」として一覧に残す

このモジュールはBを実装する。「要確認」になったPDFは転記せず、画面の結果一覧から
メイン画面に読み込んで、これまでどおり「4.」→「5.」(確認画面)→「6.」で1件ずつ処理する。

ログファイルには、処理日時・ファイル名・結果・ページ数・読み取り方式・候補の件数・
処理時間・理由の種類だけを書く。**部屋名など図面の中身、例外のメッセージ本文、
APIキーは書かない**(ログは共有フォルダに置かれたり、問い合わせ時に送られたりしやすいため)。

このモジュールはtkinterに依存しない。画面(`app/ui/batch_dialog.py`)は、この
`run_batch()` を別スレッドで呼び、`on_progress` で届く途中経過をメインスレッドで表示する。
"""

from __future__ import annotations

import threading
import time
import unicodedata
from collections.abc import Callable, Sequence
from dataclasses import dataclass, field
from datetime import datetime
from pathlib import Path
from typing import TextIO

from app.core.excel_writer import CellNotEmptyError, ExcelWriteError, write_rooms_to_excel
from app.core.mapping import MappingError, TemplateMapping, plan_cells
from app.core.ocr_local import OcrError
from app.core.pdf_loader import DEFAULT_DPI, PdfDocument, PdfLoadError, RenderedPage
from app.core.review_model import SOURCE_EMBEDDED, SOURCE_OCR, ReviewedRoom, ReviewList
from app.core.room_matcher import RoomCandidate, RoomDictionary, filter_room_candidates
from app.core.text_extractor import ExtractedWord, extract_words

#: 1件ごとの結果
STATUS_SUCCESS = "success"
STATUS_REVIEW = "review"
STATUS_FAILED = "failed"
STATUS_CANCELLED = "cancelled"

STATUS_LABELS = {
    STATUS_SUCCESS: "成功",
    STATUS_REVIEW: "要確認",
    STATUS_FAILED: "失敗",
    STATUS_CANCELLED: "未処理",
}

#: 要確認・失敗の理由の種類(ログにはこの種類だけを書き、部屋名などの中身は書かない)
REASON_NO_CANDIDATES = "no_candidates"
REASON_OCR_USED = "ocr_used"
REASON_LOW_CONFIDENCE = "low_confidence"
REASON_OCR_UNAVAILABLE = "ocr_unavailable"
REASON_DUPLICATE = "duplicate"
REASON_MAPPING = "mapping"
REASON_MAPPING_SKIPPED = "mapping_skipped"
REASON_TOO_MANY_PAGES = "too_many_pages"
REASON_PDF_OPEN = "pdf_open"
REASON_OCR_ERROR = "ocr_error"
REASON_CELL_NOT_EMPTY = "cell_not_empty"
REASON_EXCEL_WRITE = "excel_write"
REASON_UNEXPECTED = "unexpected"
REASON_CANCELLED = "cancelled"

#: 出力フォルダ名・出力ファイル名・ログファイル名
OUTPUT_DIR_LABEL = "転記結果"
OUTPUT_FILE_LABEL = "転記"
LOG_FILE_NAME = "batch_log.txt"

#: OCRの信頼度(0〜100)がこれ未満の部屋名があれば要確認にする。
#: 架空サンプル図面で、150dpi相当のスキャンでは部屋名の信頼度が91〜96、72〜100dpi相当の
#: 粗いスキャンでは48〜75の部屋名が出たことから決めた暫定値(実際の図面で調整する)
DEFAULT_MIN_OCR_CONFIDENCE = 80.0

#: 1つのPDFで読むページ数の上限(大量ページのPDFが混ざっても全体が止まらないように)
DEFAULT_MAX_PAGES = 30

#: 画像化済みのページをOCRする関数(既定は `ocr_local.ocr_rendered_page`。テストでは差し替える)
OcrFunc = Callable[[RenderedPage], list[ExtractedWord]]


class BatchError(ValueError):
    """一括処理を始められない場合の例外(フォルダが無い・出力先を作れない等)。"""


class _Cancelled(Exception):
    """処理中のPDFの途中で中止の合図を受け取ったことを表す内部用の例外。"""


@dataclass(frozen=True)
class BatchOptions:
    """一括処理の設定。"""

    #: 問題の見つからなかったPDFをExcelへ転記するか(偽なら読み取りと判定だけ行う)
    write_excel: bool = True
    #: OCRで読んだPDFは、信頼度が高くても要確認にするか(読み取り漏れは信頼度に表れないため既定は真)
    ocr_always_review: bool = True
    min_ocr_confidence: float = DEFAULT_MIN_OCR_CONFIDENCE
    max_pages: int = DEFAULT_MAX_PAGES
    #: OCRに使う画像化の解像度
    ocr_dpi: int = DEFAULT_DPI


@dataclass(frozen=True)
class Reason:
    """要確認・失敗の理由。`message` は画面用(部屋名を含みうる)、`code` はログ用。"""

    code: str
    message: str
    #: ログに書く件数(部屋名そのものではなく件数だけを書く)
    count: int | None = None

    def for_log(self) -> str:
        return self.code if self.count is None else f"{self.code}({self.count})"


@dataclass(frozen=True)
class FileResult:
    """PDF1件分の結果(画面の結果一覧の1行)。"""

    pdf_path: Path
    status: str
    reasons: tuple[Reason, ...] = ()
    page_count: int = 0
    #: 読み取りに使った方式("embedded"・"ocr")
    sources: tuple[str, ...] = ()
    #: 部屋名候補(二重検出をまとめたあと。画面にだけ表示し、ログには書かない)
    rooms: tuple[str, ...] = ()
    output_path: Path | None = None
    elapsed_seconds: float = 0.0

    @property
    def status_label(self) -> str:
        return STATUS_LABELS[self.status]

    @property
    def reason_text(self) -> str:
        return "/".join(reason.message for reason in self.reasons)


@dataclass(frozen=True)
class BatchProgress:
    """途中経過。1件の開始時(`result` が `None`)と終了時に1回ずつ届く。"""

    index: int  # 1始まり
    total: int
    pdf_path: Path
    result: FileResult | None = None


@dataclass(frozen=True)
class BatchSummary:
    """一括処理全体の結果。"""

    results: list[FileResult]
    output_dir: Path
    log_path: Path
    cancelled: bool
    elapsed_seconds: float
    counts: dict[str, int] = field(default_factory=dict)


# --- 対象ファイル・出力先 --------------------------------------------------------


def list_pdf_files(folder: str | Path) -> list[Path]:
    """フォルダ直下のPDFを名前順に返す(サブフォルダの中は見ない)。

    拡張子の大文字小文字は区別しない(`.PDF` も対象)。Officeの一時ファイル(`~$` で始まる)と
    隠しファイル(`.` で始まる)は除く。
    """
    directory = Path(folder)
    if not directory.is_dir():
        raise BatchError(f"フォルダが見つかりません: {directory}")
    files = [
        path
        for path in directory.iterdir()
        if path.is_file() and path.suffix.lower() == ".pdf" and not path.name.startswith(("~$", "."))
    ]
    return sorted(files, key=lambda p: unicodedata.normalize("NFKC", p.name).casefold())


def make_output_dir(parent: str | Path, *, now: datetime | None = None) -> Path:
    """出力フォルダ `転記結果_<日時>` を作って返す。同じ名前があれば `_2`、`_3`…を付ける。"""
    base_dir = Path(parent)
    stamp = (now or datetime.now()).strftime("%Y%m%d-%H%M%S")
    candidate = base_dir / f"{OUTPUT_DIR_LABEL}_{stamp}"
    counter = 2
    while candidate.exists():
        candidate = base_dir / f"{OUTPUT_DIR_LABEL}_{stamp}_{counter}"
        counter += 1
    try:
        candidate.mkdir(parents=True)
    except OSError as exc:
        raise BatchError(f"出力フォルダを作れませんでした(書き込み権限を確認してください): {candidate}") from exc
    return candidate


def unique_output_path(output_dir: Path, pdf_path: Path, suffix: str, reserved: set[str]) -> Path:
    """PDFごとの出力ファイル名を決める(例:`A邸.pdf` → `A邸_転記.xlsx`)。

    次の場合に名前がぶつかるため、`_2`、`_3`…を付けて避ける。

    - 出力フォルダに同じ名前のファイルが既にある
    - 大文字小文字・全角半角だけが違うPDF(`A.pdf` と `a.PDF`)。Windowsでは同じ名前として扱われる
    """
    base = f"{pdf_path.stem}_{OUTPUT_FILE_LABEL}"
    counter = 1
    while True:
        name = f"{base}{suffix}" if counter == 1 else f"{base}_{counter}{suffix}"
        key = unicodedata.normalize("NFKC", name).casefold()
        if key not in reserved and not (output_dir / name).exists():
            reserved.add(key)
            return output_dir / name
        counter += 1


# --- 1件分の処理 ----------------------------------------------------------------


def _default_ocr_func() -> OcrFunc | None:
    """Tesseractが使えればローカルOCRの関数を、使えなければ `None` を返す。"""
    from app.core.ocr_local import is_tesseract_available, ocr_rendered_page

    return ocr_rendered_page if is_tesseract_available() else None


def _read_pdf(
    pdf_path: Path,
    dictionary: RoomDictionary,
    options: BatchOptions,
    ocr_func: OcrFunc | None,
    cancel_event: threading.Event | None,
) -> tuple[int, list[RoomCandidate], list[str], list[Reason]]:
    """PDFの全ページ(上限まで)を読み、部屋名候補・使った方式・要確認の理由を返す。"""
    reasons: list[Reason] = []
    sources: list[str] = []
    candidates: list[RoomCandidate] = []
    ocr_skipped_pages = 0
    with PdfDocument(pdf_path) as document:
        page_count = document.page_count
        pages = min(page_count, options.max_pages)
        if page_count > options.max_pages:
            reasons.append(
                Reason(
                    REASON_TOO_MANY_PAGES,
                    f"{page_count}ページあるため、先頭の{options.max_pages}ページだけ読みました",
                    page_count,
                )
            )
        for page_number in range(pages):
            if cancel_event is not None and cancel_event.is_set():
                raise _Cancelled
            words = extract_words(document, page_number)
            source = SOURCE_EMBEDDED
            if not words:
                if ocr_func is None:
                    ocr_skipped_pages += 1
                    continue
                rendered = document.render_page(page_number, zoom=1.0, dpi=options.ocr_dpi)
                words = ocr_func(rendered)
                source = SOURCE_OCR
            if source not in sources:
                sources.append(source)
            candidates.extend(filter_room_candidates(words, dictionary))
    if ocr_skipped_pages:
        reasons.append(
            Reason(
                REASON_OCR_UNAVAILABLE,
                f"埋め込み文字の無いページが{ocr_skipped_pages}ページありますが、Tesseractが無いためOCRできません",
                ocr_skipped_pages,
            )
        )
    return page_count, candidates, sources, reasons


def _judge(
    candidates: list[RoomCandidate],
    review: ReviewList,
    sources: list[str],
    options: BatchOptions,
) -> list[Reason]:
    """機械的に判定できる「人が見るべき点」を洗い出す。"""
    reasons: list[Reason] = []
    items = review.items
    if not items:
        reasons.append(Reason(REASON_NO_CANDIDATES, "部屋名候補が0件です(図面に文字が無い・辞書に無い表記の可能性)"))
    if SOURCE_OCR in sources:
        low = [
            (c.word.text, c.word.confidence)
            for c in candidates
            if c.word.confidence is not None and c.word.confidence < options.min_ocr_confidence
        ]
        if low:
            detail = "、".join(f"{text}({confidence:.0f})" for text, confidence in low)
            reasons.append(
                Reason(
                    REASON_LOW_CONFIDENCE,
                    f"OCRの信頼度が{options.min_ocr_confidence:.0f}未満:{detail}",
                    len(low),
                )
            )
        if options.ocr_always_review:
            reasons.append(Reason(REASON_OCR_USED, "スキャン図面(OCRで読み取り)のため、読み取り漏れがないか確認が必要です"))
    duplicates = sorted({review.get(item_id).name for item_id in review.duplicate_ids()})
    if duplicates:
        reasons.append(Reason(REASON_DUPLICATE, f"同じ部屋名が複数あります:{'、'.join(duplicates)}", len(duplicates)))
    return reasons


def process_pdf(
    pdf_path: str | Path,
    *,
    template: Path,
    mapping: TemplateMapping,
    dictionary: RoomDictionary,
    output_path: Path,
    options: BatchOptions | None = None,
    ocr_func: OcrFunc | None = None,
    cancel_event: threading.Event | None = None,
) -> FileResult:
    """PDF1件を読み取り・判定し、問題が無ければ `output_path` へ転記する。

    例外はここで受け止めて「失敗」の結果に変える(呼び出し側の繰り返しを止めない)。
    """
    options = options or BatchOptions()
    path = Path(pdf_path)
    started = time.perf_counter()

    def result(status: str, reasons: list[Reason], **kwargs: object) -> FileResult:
        return FileResult(
            pdf_path=path,
            status=status,
            reasons=tuple(reasons),
            elapsed_seconds=time.perf_counter() - started,
            **kwargs,  # type: ignore[arg-type]
        )

    page_count = 0
    sources: list[str] = []
    rooms: tuple[str, ...] = ()
    try:
        page_count, candidates, sources, reasons = _read_pdf(path, dictionary, options, ocr_func, cancel_event)
        review = ReviewList.from_candidates(
            candidates, source=SOURCE_OCR if SOURCE_OCR in sources else SOURCE_EMBEDDED, dictionary=dictionary
        )
        rooms = tuple(item.name for item in review.items)
        reasons += _judge(candidates, review, sources, options)

        names = list(rooms)
        if names:
            try:
                plan = plan_cells(mapping, names, dictionary)
            except MappingError as exc:
                reasons.append(Reason(REASON_MAPPING, f"テンプレートの欄に合いません:{exc}"))
            else:
                if plan.skipped:
                    reasons.append(
                        Reason(
                            REASON_MAPPING_SKIPPED,
                            f"欄が無いため書き込まない部屋名があります:{'、'.join(plan.skipped)}",
                            len(plan.skipped),
                        )
                    )

        common = {"page_count": page_count, "sources": tuple(sources), "rooms": rooms}
        if reasons:
            return result(STATUS_REVIEW, reasons, **common)
        if not options.write_excel:
            return result(STATUS_SUCCESS, [], **common)

        reviewed = [
            ReviewedRoom(
                name=item.name,
                canonical_name=item.canonical_name,
                page_number=item.page_number,
                bbox=item.bbox,
                source=item.source,
                edited=False,
            )
            for item in review.items
        ]
        written = write_rooms_to_excel(
            template, reviewed, output_path=output_path, mapping=mapping, dictionary=dictionary
        )
        return result(STATUS_SUCCESS, [], output_path=written.output_path, **common)
    except _Cancelled:
        return result(STATUS_CANCELLED, [Reason(REASON_CANCELLED, "中止したため処理していません")], page_count=page_count)
    except PdfLoadError as exc:
        return result(STATUS_FAILED, [Reason(REASON_PDF_OPEN, str(exc))], page_count=page_count)
    except OcrError as exc:
        return result(STATUS_FAILED, [Reason(REASON_OCR_ERROR, str(exc))], page_count=page_count)
    except CellNotEmptyError as exc:
        return result(STATUS_FAILED, [Reason(REASON_CELL_NOT_EMPTY, str(exc))], page_count=page_count, rooms=rooms)
    except ExcelWriteError as exc:
        return result(STATUS_FAILED, [Reason(REASON_EXCEL_WRITE, str(exc))], page_count=page_count, rooms=rooms)
    except Exception as exc:  # 想定外のエラーでも、このPDFを「失敗」にして次へ進む
        message = f"想定外のエラー({type(exc).__name__}):{exc}"
        return result(
            STATUS_FAILED, [Reason(f"{REASON_UNEXPECTED}:{type(exc).__name__}", message)], page_count=page_count
        )


# --- ログ ----------------------------------------------------------------------


class BatchLog:
    """一括処理のログファイル。1件終わるごとに書き出す(途中で止まっても、そこまでは残る)。

    書くのは日時・ファイル名・結果・ページ数・方式・候補の件数・処理時間・理由の種類だけ。
    部屋名・例外のメッセージ本文・APIキーは書かない。
    """

    def __init__(self, path: Path, *, clock: Callable[[], datetime] = datetime.now) -> None:
        self.path = path
        self._clock = clock
        self._file: TextIO = path.open("w", encoding="utf-8", newline="\n")

    def header(self, *, folder: Path, template: Path, mapping: TemplateMapping, total: int, options: BatchOptions) -> None:
        self._write(f"# madori-ocr 一括処理ログ 開始 {self._now()}")
        self._write(f"# 対象フォルダ: {folder}")
        self._write(f"# テンプレート: {template.name} / 転記の設定: {mapping.id}")
        self._write(
            f"# 対象: {total}件 / Excelへ転記: {'する' if options.write_excel else 'しない'}"
            f" / OCRの信頼度しきい値: {options.min_ocr_confidence:.0f}"
            f" / OCRは常に要確認: {'はい' if options.ocr_always_review else 'いいえ'}"
        )

    def file_result(self, index: int, total: int, result: FileResult) -> None:
        parts = [
            f"[{self._now()}]",
            f"{index}/{total}",
            result.pdf_path.name,
            f"結果={result.status_label}",
            f"ページ={result.page_count}",
            f"方式={'+'.join(result.sources) or '-'}",
            f"候補={len(result.rooms)}件",
            f"時間={result.elapsed_seconds:.2f}秒",
        ]
        if result.reasons:
            parts.append("理由=" + ",".join(reason.for_log() for reason in result.reasons))
        if result.output_path is not None:
            parts.append(f"出力={result.output_path.name}")
        self._write(" ".join(parts))

    def footer(self, counts: dict[str, int], *, cancelled: bool, elapsed: float) -> None:
        summary = " / ".join(f"{STATUS_LABELS[status]} {counts.get(status, 0)}" for status in STATUS_LABELS)
        self._write(f"# 終了 {self._now()} {summary} / 合計時間 {elapsed:.1f}秒" + (" / 中止あり" if cancelled else ""))

    def close(self) -> None:
        self._file.close()

    def _now(self) -> str:
        return self._clock().strftime("%Y-%m-%d %H:%M:%S")

    def _write(self, line: str) -> None:
        self._file.write(line + "\n")
        self._file.flush()


# --- 全体 ----------------------------------------------------------------------


def run_batch(
    pdf_paths: Sequence[str | Path],
    *,
    template: str | Path,
    mapping: TemplateMapping,
    dictionary: RoomDictionary,
    output_dir: str | Path,
    options: BatchOptions | None = None,
    on_progress: Callable[[BatchProgress], None] | None = None,
    cancel_event: threading.Event | None = None,
    ocr_func: OcrFunc | None | bool = True,
    clock: Callable[[], datetime] = datetime.now,
) -> BatchSummary:
    """PDFを1件ずつ処理する。1件が失敗しても残りは続ける。

    - `output_dir`:Excelとログの出力先(`make_output_dir()` で作ったフォルダを渡す)
    - `on_progress`:各PDFの開始時・終了時に呼ばれる(別スレッドから呼ばれうるので、画面は直接触らない)
    - `cancel_event`:セットされると、処理中のPDFのページの区切りか次のPDFの前で止まり、
      残りを「未処理」にする
    - `ocr_func`:`True`(既定)ならTesseractがあればローカルOCRを使う。`None` ならOCRしない。
      テストではダミーの関数を渡す
    """
    options = options or BatchOptions()
    template_path = Path(template)
    out_dir = Path(output_dir)
    if not template_path.is_file():
        raise BatchError(f"Excelテンプレートが見つかりません: {template_path}")
    if not out_dir.is_dir():
        raise BatchError(f"出力フォルダが見つかりません: {out_dir}")
    paths = [Path(p) for p in pdf_paths]
    ocr: OcrFunc | None = _default_ocr_func() if ocr_func is True else (ocr_func or None)  # type: ignore[assignment]

    started = time.perf_counter()
    log = BatchLog(out_dir / LOG_FILE_NAME, clock=clock)
    results: list[FileResult] = []
    reserved: set[str] = set()
    cancelled = False
    try:
        log.header(
            folder=paths[0].parent if paths else out_dir,
            template=template_path,
            mapping=mapping,
            total=len(paths),
            options=options,
        )
        for index, pdf_path in enumerate(paths, start=1):
            if cancel_event is not None and cancel_event.is_set():
                cancelled = True
                result = FileResult(
                    pdf_path=pdf_path,
                    status=STATUS_CANCELLED,
                    reasons=(Reason(REASON_CANCELLED, "中止したため処理していません"),),
                )
            else:
                if on_progress is not None:
                    on_progress(BatchProgress(index=index, total=len(paths), pdf_path=pdf_path))
                output_path = unique_output_path(out_dir, pdf_path, template_path.suffix, reserved)
                result = process_pdf(
                    pdf_path,
                    template=template_path,
                    mapping=mapping,
                    dictionary=dictionary,
                    output_path=output_path,
                    options=options,
                    ocr_func=ocr,
                    cancel_event=cancel_event,
                )
                if result.status == STATUS_CANCELLED:
                    cancelled = True
            results.append(result)
            log.file_result(index, len(paths), result)
            if on_progress is not None:
                on_progress(BatchProgress(index=index, total=len(paths), pdf_path=pdf_path, result=result))
        counts = {status: sum(1 for r in results if r.status == status) for status in STATUS_LABELS}
        elapsed = time.perf_counter() - started
        log.footer(counts, cancelled=cancelled, elapsed=elapsed)
    finally:
        log.close()
    return BatchSummary(
        results=results,
        output_dir=out_dir,
        log_path=log.path,
        cancelled=cancelled,
        elapsed_seconds=elapsed,
        counts=counts,
    )


def describe_summary(summary: BatchSummary) -> str:
    """結果一覧の下に出す集計(例:「成功 2件・要確認 4件・失敗 1件・未処理 0件(合計 3.2秒)」)。"""
    parts = "・".join(f"{STATUS_LABELS[status]} {summary.counts.get(status, 0)}件" for status in STATUS_LABELS)
    note = "(中止しました)" if summary.cancelled else ""
    return f"{parts}(合計 {summary.elapsed_seconds:.1f}秒){note}"
app/core/background.py を新しく作ります(全文)。
app/core/background.py の全文(141行)
# app/core/background.py
"""時間のかかる処理を別スレッドで動かし、結果・途中経過を画面のスレッドへ渡す仕組み(第9回)。

第5回の時点では、外部AIの呼び出しやOCRを「ボタンを押した処理の中」でそのまま
実行していた。tkinterは画面の再描画もボタンのクリックも1本のスレッド
(メインスレッド)のイベントループで処理するため、その間は画面が固まる
(ウィンドウを動かしても再描画されず、中止ボタンも押せない)。

そこで、重い処理は別スレッド(ワーカースレッド)で実行し、画面の更新は
メインスレッドだけで行う。両者の間は `queue.Queue`(スレッド間で安全に
受け渡しできる待ち行列)でつなぎ、メインスレッドは `after()`(一定時間後に
関数を呼んでもらうtkinterの仕組み)で定期的にキューを見に行く。

    ワーカースレッド                       メインスレッド(tkinter)
    ─────────────────                      ───────────────────────
    job.post(途中経過) ──▶ queue ──▶ after(100ms)ごとに取り出して on_message()
    return 結果       ──▶ queue ──▶ on_done(結果) / on_error(例外)

このモジュールはtkinterをimportしない。「一定時間後に呼んでもらう関数」
(tkinterなら `widget.after`)を `schedule` 引数で受け取るため、pytestでは
ダミーの `schedule` を渡してスレッドの受け渡しを検証できる。

ワーカースレッドの中からtkinterのウィジェット(ラベル・進捗バーなど)を
直接触ってはいけない。途中経過を画面に出したいときは `job.post()` で
キューに入れ、メインスレッド側の `on_message` で画面を更新する。
"""

from __future__ import annotations

import queue
import threading
from collections.abc import Callable
from typing import Any

#: キューを見に行く間隔(ミリ秒)。短すぎると無駄に動き、長すぎると表示が遅れる
DEFAULT_POLL_MS = 100

Scheduler = Callable[[int, Callable[[], None]], Any]

_KIND_MESSAGE = "message"
_KIND_DONE = "done"
_KIND_ERROR = "error"


class BackgroundJob:
    """1つの処理を別スレッドで実行し、結果をメインスレッドのコールバックへ渡す。

    使い方(画面側)::

        job = BackgroundJob(
            work,                      # work(job) を別スレッドで実行する関数
            schedule=self.after,       # tkinterの after
            on_done=self._on_done,     # 戻り値を受け取る(メインスレッドで呼ばれる)
            on_error=self._on_error,   # 例外を受け取る(メインスレッドで呼ばれる)
            on_message=self._on_progress,  # job.post() の値を受け取る(メインスレッドで呼ばれる)
        )
        job.start()
        ...
        job.cancel()  # 中止ボタン。work 側が job.cancelled を見て早めに終わる

    `cancel()` は「止まってほしい」という合図を出すだけで、実行中のOCRや通信を
    途中で強制終了するわけではない(Pythonのスレッドは外から安全に止められない)。
    `work` 側で区切りのよいところ(1ファイル・1ページごと)に `job.cancelled` を確認する。
    """

    def __init__(
        self,
        work: Callable[[BackgroundJob], Any],
        *,
        schedule: Scheduler,
        on_done: Callable[[Any], None],
        on_error: Callable[[BaseException], None],
        on_message: Callable[[Any], None] | None = None,
        poll_ms: int = DEFAULT_POLL_MS,
    ) -> None:
        self._work = work
        self._schedule = schedule
        self._on_done = on_done
        self._on_error = on_error
        self._on_message = on_message
        self._poll_ms = poll_ms
        self._queue: queue.Queue[tuple[str, Any]] = queue.Queue()
        self._cancel_event = threading.Event()
        self._thread: threading.Thread | None = None
        self._finished = False

    @property
    def cancel_event(self) -> threading.Event:
        """中止の合図。コア処理(`batch.run_batch()` など)にそのまま渡せる。"""
        return self._cancel_event

    @property
    def cancelled(self) -> bool:
        return self._cancel_event.is_set()

    @property
    def finished(self) -> bool:
        """結果(またはエラー)をメインスレッドへ渡し終えたか。"""
        return self._finished

    def start(self) -> None:
        if self._thread is not None:
            raise RuntimeError("この処理はすでに開始しています。")
        # daemon=True:処理の途中でウィンドウを閉じても、アプリの終了を妨げないようにする
        self._thread = threading.Thread(target=self._run, name="madori-ocr-worker", daemon=True)
        self._thread.start()
        self._schedule(self._poll_ms, self._poll)

    def cancel(self) -> None:
        self._cancel_event.set()

    def post(self, message: Any) -> None:
        """ワーカースレッドから途中経過を送る(画面は触らず、キューに入れるだけ)。"""
        self._queue.put((_KIND_MESSAGE, message))

    def _run(self) -> None:
        try:
            result = self._work(self)
        except BaseException as exc:  # どんな例外でも画面側へ渡し、スレッドの中で握りつぶさない
            self._queue.put((_KIND_ERROR, exc))
        else:
            self._queue.put((_KIND_DONE, result))

    def _poll(self) -> None:
        """メインスレッドで呼ばれ、キューにたまったものを順に取り出してコールバックへ渡す。"""
        while True:
            try:
                kind, payload = self._queue.get_nowait()
            except queue.Empty:
                break
            if kind == _KIND_MESSAGE:
                if self._on_message is not None:
                    self._on_message(payload)
                continue
            self._finished = True
            if kind == _KIND_DONE:
                self._on_done(payload)
            else:
                self._on_error(payload)
            return  # 完了したので、これ以上キューを見に行かない
        self._schedule(self._poll_ms, self._poll)
app/ui/batch_dialog.py を新しく作ります(全文)。
app/ui/batch_dialog.py の全文(324行)
# app/ui/batch_dialog.py
"""フォルダ内の図面PDFをまとめて処理する画面(第9回)。

フォルダを選んで「開始」を押すと、`app/core/batch.py` の `run_batch()` を別スレッドで
実行する(`app/core/background.py` の `BackgroundJob`)。画面のスレッド(メインスレッド)は
処理を待たずにイベントループへ戻るため、処理中も画面は固まらず、進捗バーの更新や
「中止」ボタンの操作ができる。

- 別スレッドからは画面を一切触らない。`run_batch()` の途中経過(`BatchProgress`)は
  `job.post()` でキューに入れ、メインスレッドの `_on_progress()` で進捗バーと一覧を更新する
- 「中止」は合図を出すだけ。処理中のページのOCRが終わった区切りで止まり、残りは「未処理」になる
- この画面を開いている間はメイン画面を操作できない(モーダル)。PyMuPDFを画面のスレッドと
  一括処理のスレッドから同時に呼ばないようにするため(`pdf_loader.PDF_LOCK` と二重の対策)

結果一覧で「要確認」「失敗」の行をダブルクリックすると、画面を閉じてそのPDFをメイン画面に
読み込む。そこから先は、これまでどおり「4.」→「5.」(確認画面)→「6.」で1件ずつ処理する。
"""

from __future__ import annotations

import tkinter as tk
from collections.abc import Callable
from pathlib import Path
from tkinter import filedialog, messagebox, ttk

from app.core.background import BackgroundJob
from app.core.batch import (
    STATUS_CANCELLED,
    STATUS_FAILED,
    STATUS_REVIEW,
    STATUS_SUCCESS,
    BatchError,
    BatchOptions,
    BatchProgress,
    BatchSummary,
    FileResult,
    describe_summary,
    list_pdf_files,
    make_output_dir,
    run_batch,
)
from app.core.mapping import TemplateMapping, describe_mapping
from app.core.room_matcher import RoomDictionary

DIALOG_TITLE = "フォルダ内のPDFをまとめて処理"
DIALOG_SIZE = "1080x560"

#: 結果の種類ごとの行の背景色
_ROW_COLORS = {
    STATUS_SUCCESS: "#e3f4e1",
    STATUS_REVIEW: "#fff4c2",
    STATUS_FAILED: "#ffd9d9",
    STATUS_CANCELLED: "#eeeeee",
}


class BatchDialog(tk.Toplevel):
    """一括処理の画面(フォルダ選択・開始/中止・進捗バー・結果一覧)。"""

    def __init__(
        self,
        master: tk.Misc,
        *,
        template: Path,
        mapping: TemplateMapping,
        dictionary: RoomDictionary,
        on_open_pdf: Callable[[Path], None],
    ) -> None:
        super().__init__(master)
        self.title(DIALOG_TITLE)
        self.geometry(DIALOG_SIZE)
        self._template = template
        self._mapping = mapping
        self._dictionary = dictionary
        self._on_open_pdf = on_open_pdf
        self._folder: Path | None = None
        self._job: BackgroundJob | None = None
        self._close_when_done = False
        self._results: dict[str, FileResult] = {}
        self.summary: BatchSummary | None = None

        self.folder_var = tk.StringVar(value="未選択")
        self.progress_var = tk.StringVar(value="フォルダを選んで「開始」を押してください。")
        self.summary_var = tk.StringVar(value="")
        self.write_excel_var = tk.BooleanVar(value=True)
        self.ocr_review_var = tk.BooleanVar(value=True)

        self._build_widgets()
        self.protocol("WM_DELETE_WINDOW", self._on_close)

    def _build_widgets(self) -> None:
        frame = ttk.Frame(self, padding=12)
        frame.pack(fill="both", expand=True)
        frame.columnconfigure(0, weight=1)
        frame.rowconfigure(6, weight=1)

        top = ttk.Frame(frame)
        top.grid(row=0, column=0, sticky="ew")
        ttk.Label(top, text="PDFのフォルダ:").pack(side="left")
        self.choose_button = ttk.Button(top, text="フォルダを選ぶ...", command=self._on_choose_folder)
        self.choose_button.pack(side="left")
        ttk.Label(top, textvariable=self.folder_var, foreground="#555555").pack(side="left", padx=(8, 0))

        ttk.Label(
            frame,
            text=(
                f"テンプレート:{self._template.name} 転記の設定:{describe_mapping(self._mapping)}\n"
                "読み取り方式:ローカル(埋め込み文字→無ければOCR)。一括処理では外部AIへ図面を送信しません。"
            ),
            foreground="#555555",
        ).grid(row=1, column=0, sticky="w", pady=(6, 4))

        options = ttk.Frame(frame)
        options.grid(row=2, column=0, sticky="w")
        self.write_excel_check = ttk.Checkbutton(
            options, text="問題が見つからなかったPDFはExcelへ転記する", variable=self.write_excel_var
        )
        self.write_excel_check.pack(side="left")
        self.ocr_review_check = ttk.Checkbutton(
            options, text="スキャン図面(OCR)は信頼度が高くても「要確認」にする", variable=self.ocr_review_var
        )
        self.ocr_review_check.pack(side="left", padx=(12, 0))

        buttons = ttk.Frame(frame)
        buttons.grid(row=3, column=0, sticky="w", pady=(8, 4))
        self.start_button = ttk.Button(buttons, text="開始", command=self._on_start, state="disabled")
        self.start_button.pack(side="left")
        self.cancel_button = ttk.Button(buttons, text="中止", command=self._on_cancel, state="disabled")
        self.cancel_button.pack(side="left", padx=(8, 0))

        self.progressbar = ttk.Progressbar(frame, mode="determinate", maximum=1)
        self.progressbar.grid(row=4, column=0, sticky="ew")
        ttk.Label(frame, textvariable=self.progress_var).grid(row=5, column=0, sticky="w", pady=(2, 6))

        columns = ("status", "file", "rooms", "reason", "output")
        self.tree = ttk.Treeview(frame, columns=columns, show="headings", height=9)
        for column, heading, width in [
            ("status", "結果", 60),
            ("file", "ファイル名", 230),
            ("rooms", "候補数", 60),
            ("reason", "要確認・失敗の理由", 500),
            ("output", "出力ファイル", 200),
        ]:
            self.tree.heading(column, text=heading)
            self.tree.column(column, width=width, anchor="center" if column in ("status", "rooms") else "w")
        for status, color in _ROW_COLORS.items():
            self.tree.tag_configure(status, background=color)
        self.tree.grid(row=6, column=0, sticky="nsew")
        scroll = ttk.Scrollbar(frame, orient="vertical", command=self.tree.yview)
        scroll.grid(row=6, column=1, sticky="ns")
        self.tree.configure(yscrollcommand=scroll.set)
        self.tree.bind("<Double-1>", self._on_double_click)

        ttk.Label(frame, textvariable=self.summary_var, foreground="#1a6b2a").grid(row=7, column=0, sticky="w", pady=(6, 0))
        bottom = ttk.Frame(frame)
        bottom.grid(row=8, column=0, sticky="ew", pady=(4, 0))
        ttk.Label(
            bottom,
            text="「要確認」「失敗」の行をダブルクリックすると、そのPDFをメイン画面に読み込みます(「4.」→「5.」→「6.」で1件ずつ処理)。",
            foreground="#555555",
        ).pack(side="left")
        self.close_button = ttk.Button(bottom, text="閉じる", command=self._on_close)
        self.close_button.pack(side="right")

    # --- 操作 ------------------------------------------------------------------

    def _on_choose_folder(self) -> None:
        folder = filedialog.askdirectory(title="図面PDFの入ったフォルダを選択", parent=self)
        if not folder:
            return
        try:
            pdfs = list_pdf_files(folder)
        except BatchError as exc:
            messagebox.showerror("フォルダのエラー", str(exc), parent=self)
            return
        self._folder = Path(folder)
        self.folder_var.set(f"{folder}(PDF {len(pdfs)}件)")
        self.start_button.configure(state="normal" if pdfs else "disabled")
        if not pdfs:
            self.progress_var.set("このフォルダ(直下)にはPDFがありません。")

    def _on_start(self) -> None:
        if self._folder is None or self._job is not None:
            return
        try:
            pdfs = list_pdf_files(self._folder)
            if not pdfs:
                raise BatchError("このフォルダ(直下)にはPDFがありません。")
            output_dir = make_output_dir(self._folder)
        except BatchError as exc:
            messagebox.showerror("一括処理を開始できません", str(exc), parent=self)
            return

        options = BatchOptions(write_excel=self.write_excel_var.get(), ocr_always_review=self.ocr_review_var.get())
        self.tree.delete(*self.tree.get_children())
        self._results.clear()
        self.summary = None
        self.summary_var.set(f"出力フォルダ:{output_dir}")
        self.progressbar.configure(maximum=len(pdfs), value=0)
        self._set_running(True)

        def work(job: BackgroundJob) -> BatchSummary:
            # ここは別スレッドで動く。画面(ウィジェット)には触らず、途中経過は job.post で送る
            return run_batch(
                pdfs,
                template=self._template,
                mapping=self._mapping,
                dictionary=self._dictionary,
                output_dir=output_dir,
                options=options,
                on_progress=job.post,
                cancel_event=job.cancel_event,
            )

        self._job = BackgroundJob(
            work, schedule=self.after, on_done=self._on_done, on_error=self._on_error, on_message=self._on_progress
        )
        self._job.start()

    def _on_cancel(self) -> None:
        if self._job is None:
            return
        self._job.cancel()
        self.cancel_button.configure(state="disabled")
        self.progress_var.set("中止しています…(処理中のページが終わりしだい止まります)")

    def _on_close(self) -> None:
        if self._job is not None:
            if not messagebox.askyesno(
                "処理中です", "一括処理を中止して閉じますか?(処理済みのファイルとログは残ります)", parent=self
            ):
                return
            self._close_when_done = True
            self._on_cancel()
            return
        self.destroy()

    def _on_double_click(self, _event: tk.Event) -> None:
        if self._job is not None:
            return
        selection = self.tree.selection()
        if not selection:
            return
        result = self._results.get(selection[0])
        if result is None or result.status not in (STATUS_REVIEW, STATUS_FAILED):
            return
        self.destroy()
        self._on_open_pdf(result.pdf_path)

    # --- 別スレッドからの知らせ(すべてメインスレッドで呼ばれる) -------------------------

    def _on_progress(self, progress: BatchProgress) -> None:
        if progress.result is None:
            self.progressbar.configure(value=progress.index - 1)
            self.progress_var.set(f"{progress.index} / {progress.total}件目:{progress.pdf_path.name} を処理中…")
            return
        self.progressbar.configure(value=progress.index)
        self._add_row(progress.result)

    def _on_done(self, summary: BatchSummary) -> None:
        self._job = None
        self.summary = summary
        # 中止した場合、未処理の行は途中経過として届かないので、ここでまとめて追加する
        for result in summary.results[len(self._results) :]:
            self._add_row(result)
        self._set_running(False)
        self.progress_var.set("中止しました。" if summary.cancelled else "すべてのPDFを処理しました。")
        self.summary_var.set(f"{describe_summary(summary)} 出力フォルダ:{summary.output_dir}")
        if self._close_when_done:
            self.destroy()

    def _on_error(self, exc: BaseException) -> None:
        self._job = None
        self._set_running(False)
        self.progress_var.set("一括処理が途中で止まりました。")
        messagebox.showerror("一括処理のエラー", f"{type(exc).__name__}: {exc}", parent=self)
        if self._close_when_done:
            self.destroy()

    # --- 表示 ------------------------------------------------------------------

    def _add_row(self, result: FileResult) -> None:
        iid = self.tree.insert(
            "",
            "end",
            values=(
                result.status_label,
                result.pdf_path.name,
                f"{len(result.rooms)}件",
                result.reason_text or "—",
                result.output_path.name if result.output_path else "",
            ),
            tags=(result.status,),
        )
        self._results[iid] = result
        self.tree.see(iid)

    def _set_running(self, running: bool) -> None:
        state = "disabled" if running else "normal"
        for widget in (self.choose_button, self.write_excel_check, self.ocr_review_check):
            widget.configure(state=state)
        self.start_button.configure(state="disabled" if running or self._folder is None else "normal")
        self.cancel_button.configure(state="normal" if running else "disabled")


def open_batch_dialog(
    master: tk.Misc,
    *,
    template: Path,
    mapping: TemplateMapping,
    dictionary: RoomDictionary,
    on_open_pdf: Callable[[Path], None],
) -> BatchDialog:
    """一括処理の画面をモーダルで開く(閉じるまでメイン画面は操作できない)。

    確認画面(第6回)と違い、ここでは閉じるのを待たずに戻る。処理は別スレッドで進み、
    メイン画面のイベントループがそのまま画面を更新し続ける。
    """
    dialog = BatchDialog(master, template=template, mapping=mapping, dictionary=dictionary, on_open_pdf=on_open_pdf)
    dialog.transient(master.winfo_toplevel())
    dialog.wait_visibility()
    dialog.grab_set()
    dialog.focus_set()
    return dialog
既存のコア処理は、PyMuPDFを呼ぶ区間をロックで囲み、画像化とOCR・外部AIの呼び出しを分けます。
app/core/pdf_loader.py に次の変更を加えます(+ が追加、- が削除)。
app/core/pdf_loader.py の差分(108行)
--- a/app/core/pdf_loader.py
+++ b/app/core/pdf_loader.py
@@ -7,10 +7,18 @@ PyMuPDF(`import fitz`)だけに依存し、tkinterなどのGUIライブラ
 プレビュー表示(`app/ui/preview_canvas.py`)は、ここで作った `RenderedPage.ppm_bytes`
 を `tkinter.PhotoImage(data=...)` にそのまま渡すだけで画像を表示できる。PPM形式は
 tkinterのPhotoImageが標準で読めるため、Pillow等の追加ライブラリを増やさずに済む。
+
+第9回で、一括処理(`app/core/batch.py`)を画面とは別のスレッドで動かすようにした。
+PyMuPDFの公式ドキュメントには「複数のスレッドで動かすことはサポートしていない」と
+明記されているため、PyMuPDFを呼ぶ処理はすべてモジュール共通のロック `PDF_LOCK` の
+内側で行い、**同時に2つのスレッドからPyMuPDFを呼ばない**ようにしている
+(ロックを取るのはPDFを開く・閉じる・画像化する・文字を取り出す短い区間だけで、
+OCRや外部AIの呼び出しの間は取らない)。
 """

 from __future__ import annotations

+import threading
 from dataclasses import dataclass
 from pathlib import Path
 from types import TracebackType
@@ -24,6 +32,11 @@ DEFAULT_DPI = 150
 MIN_ZOOM = 0.25
 MAX_ZOOM = 4.0

+#: PyMuPDFを呼ぶ区間を囲むロック(第9回)。PyMuPDFは複数スレッドからの同時利用に
+#: 対応していないため、画面のスレッドと一括処理のスレッドが同時に呼ばないようにする。
+#: 同じスレッドが入れ子で取れるよう RLock にしている。
+PDF_LOCK = threading.RLock()
+

 class PdfLoadError(ValueError):
     """PDFを開けない、またはページ番号・拡大率が範囲外の場合に送出する例外。"""
@@ -60,14 +73,15 @@ class PdfDocument:
             raise PdfLoadError(f"ファイルが見つかりません: {resolved}")
         if not resolved.is_file():
             raise PdfLoadError(f"フォルダではなくファイルを指定してください: {resolved}")
-        try:
-            document = fitz.open(resolved)
-        except Exception as exc:  # PyMuPDFは壊れたPDFに対し様々な例外を送出しうるため広く受ける
-            raise PdfLoadError(f"PDFとして開けませんでした(破損している可能性があります): {resolved}") from exc
+        with PDF_LOCK:
+            try:
+                document = fitz.open(resolved)
+            except Exception as exc:  # PyMuPDFは壊れたPDFに対し様々な例外を送出しうるため広く受ける
+                raise PdfLoadError(f"PDFとして開けませんでした(破損している可能性があります): {resolved}") from exc

-        if document.page_count == 0:
-            document.close()
-            raise PdfLoadError(f"ページが1枚もないPDFです: {resolved}")
+            if document.page_count == 0:
+                document.close()
+                raise PdfLoadError(f"ページが1枚もないPDFです: {resolved}")

         self._document = document
         self._path = resolved
@@ -80,7 +94,8 @@ class PdfDocument:
     @property
     def page_count(self) -> int:
         """PDFの総ページ数。"""
-        return self._document.page_count
+        with PDF_LOCK:
+            return self._document.page_count

     def _validate_page_number(self, page_number: int) -> None:
         if not 0 <= page_number < self.page_count:
@@ -98,7 +113,8 @@ class PdfDocument:
         直接扱うことになる(GUIからは使わず、`app/core/` 内でのみ使う想定)。
         """
         self._validate_page_number(page_number)
-        return self._document.load_page(page_number)
+        with PDF_LOCK:
+            return self._document.load_page(page_number)

     def render_page(self, page_number: int, *, zoom: float = 1.0, dpi: int = DEFAULT_DPI) -> RenderedPage:
         """指定ページを画像化して `RenderedPage` を返す。
@@ -112,10 +128,12 @@ class PdfDocument:
         if dpi <= 0:
             raise PdfLoadError(f"dpiは正の値で指定してください: {dpi}")

-        page = self._document.load_page(page_number)
         scale = (dpi / 72.0) * zoom
-        matrix = fitz.Matrix(scale, scale)
-        pixmap = page.get_pixmap(matrix=matrix, colorspace=fitz.csRGB, alpha=False)
+        with PDF_LOCK:
+            page = self._document.load_page(page_number)
+            matrix = fitz.Matrix(scale, scale)
+            pixmap = page.get_pixmap(matrix=matrix, colorspace=fitz.csRGB, alpha=False)
+            ppm_bytes = pixmap.tobytes("ppm")

         return RenderedPage(
             page_number=page_number,
@@ -123,12 +141,13 @@ class PdfDocument:
             height=pixmap.height,
             dpi=dpi,
             zoom=zoom,
-            ppm_bytes=pixmap.tobytes("ppm"),
+            ppm_bytes=ppm_bytes,
         )

     def close(self) -> None:
         """PDFファイルハンドルを閉じる。"""
-        self._document.close()
+        with PDF_LOCK:
+            self._document.close()

     def __enter__(self) -> PdfDocument:
         return self
app/core/text_extractor.py に次の変更を加えます(+ が追加、- が削除)。
--- a/app/core/text_extractor.py
+++ b/app/core/text_extractor.py
@@ -33,7 +33,7 @@ from __future__ import annotations

 from dataclasses import dataclass

-from app.core.pdf_loader import PdfDocument
+from app.core.pdf_loader import PDF_LOCK, PdfDocument


 @dataclass(frozen=True)
@@ -48,6 +48,9 @@ class ExtractedWord:
     font_size: float
     #: 単語が含まれるページ番号(0始まり)
     page_number: int
+    #: 読み取りの信頼度(0〜100)。ローカルOCRの結果にだけ入り、埋め込み文字・外部AIでは `None`
+    #: (第9回で追加。一括処理で「信頼度が低いものは要確認」と判定するために使う)
+    confidence: float | None = None


 def extract_words(document: PdfDocument, page_number: int) -> list[ExtractedWord]:
@@ -59,13 +62,12 @@ def extract_words(document: PdfDocument, page_number: int) -> list[ExtractedWord
     テキストが埋め込まれていないページ(スキャン画像のみの図面など)の場合は、
     空のリストを返す。そうしたページへの対応(ローカルOCR)は第4回で実装する。
     """
-    page = document.get_page(page_number)
-
-    word_tuples = page.get_text("words")
-    if not word_tuples:
-        return []
-
-    text_dict = page.get_text("dict")
+    with PDF_LOCK:  # 第9回:PyMuPDFを同時に2つのスレッドから呼ばない(pdf_loader.PDF_LOCK参照)
+        page = document.get_page(page_number)
+        word_tuples = page.get_text("words")
+        if not word_tuples:
+            return []
+        text_dict = page.get_text("dict")
     blocks = text_dict.get("blocks", [])

     words: list[ExtractedWord] = []
app/core/ocr_local.py に次の変更を加えます(+ が追加、- が削除)。
--- a/app/core/ocr_local.py
+++ b/app/core/ocr_local.py
@@ -40,7 +40,7 @@ from dataclasses import dataclass
 import pytesseract
 from PIL import Image, ImageFilter

-from app.core.pdf_loader import DEFAULT_DPI, PdfDocument
+from app.core.pdf_loader import DEFAULT_DPI, PdfDocument, RenderedPage
 from app.core.text_extractor import ExtractedWord

 #: OCRに使う既定の言語(日本語学習データ `jpn.traineddata` が必要)
@@ -233,6 +233,7 @@ def ocr_image_to_words(
                 bbox=bbox,
                 font_size=font_size,
                 page_number=page_number,
+                confidence=row.confidence,  # 断片を連結した場合は最も低い断片の値(第9回)
             )
         )
     return words
@@ -361,6 +362,31 @@ def ocr_pdf_page(
     委譲している(不正な場合は `PdfLoadError` が送出される)。
     """
     rendered = document.render_page(page_number, zoom=1.0, dpi=dpi)
+    return ocr_rendered_page(
+        rendered,
+        lang=lang,
+        psm=psm,
+        min_confidence=min_confidence,
+        merge_gap_ratio=merge_gap_ratio,
+        denoise=denoise,
+    )
+
+
+def ocr_rendered_page(
+    rendered: RenderedPage,
+    *,
+    lang: str = DEFAULT_OCR_LANG,
+    psm: int = DEFAULT_PSM,
+    min_confidence: float = DEFAULT_MIN_CONFIDENCE,
+    merge_gap_ratio: float = DEFAULT_MERGE_GAP_RATIO,
+    denoise: bool = False,
+) -> list[ExtractedWord]:
+    """画像化済みのページ(`RenderedPage`)をOCRする(第9回で `ocr_pdf_page()` から切り出した)。
+
+    PyMuPDFを使う「画像化」と、時間のかかる「OCR」を分けておくと、画像化だけを
+    画面のスレッドで行い、OCRを別スレッドで実行できる(PyMuPDFを別スレッドで
+    呼ばずに済む)。この関数の中ではPyMuPDFを一切呼ばない。
+    """
     image = preprocess_for_ocr(image_from_ppm_bytes(rendered.ppm_bytes), denoise=denoise)
     scale = (rendered.dpi / 72.0) * rendered.zoom
     return ocr_image_to_words(
app/core/ocr_ai.py に次の変更を加えます(+ が追加、- が削除)。
--- a/app/core/ocr_ai.py
+++ b/app/core/ocr_ai.py
@@ -47,7 +47,7 @@ import anthropic
 from PIL import Image

 from app.core.ocr_local import image_from_ppm_bytes
-from app.core.pdf_loader import DEFAULT_DPI, PdfDocument
+from app.core.pdf_loader import DEFAULT_DPI, PdfDocument, RenderedPage
 from app.core.text_extractor import ExtractedWord

 #: APIキーを読む環境変数名(値はコード・設定ファイルに書かない)
@@ -357,6 +357,21 @@ def ai_ocr_pdf_page(
     (プレビューの拡大率に結果が左右されないようにするため)。
     """
     rendered = document.render_page(page_number, zoom=1.0, dpi=dpi)
+    return ai_ocr_rendered_page(rendered, client=client, model=model, max_long_edge=max_long_edge)
+
+
+def ai_ocr_rendered_page(
+    rendered: RenderedPage,
+    *,
+    client: Any | None = None,
+    model: str | None = None,
+    max_long_edge: int = DEFAULT_MAX_LONG_EDGE,
+) -> AiOcrResult:
+    """画像化済みのページを外部AIで読み取る(第9回で `ai_ocr_pdf_page()` から切り出した)。
+
+    画面では、PyMuPDFでの画像化を画面のスレッドで済ませてから、この関数(通信を
+    含み数秒〜数十秒かかりうる)だけを別スレッドで呼ぶ。この関数の中ではPyMuPDFを呼ばない。
+    """
     image = image_from_ppm_bytes(rendered.ppm_bytes)
     base_scale = (rendered.dpi / 72.0) * rendered.zoom
     return ai_ocr_image(
メイン画面は、「7.」ボタンの追加と、「3.」「4.」の読み取りを別スレッドで動かす変更です。
app/ui/main_window.py に次の変更を加えます(+ が追加、- が削除)。
app/ui/main_window.py の差分(395行)
--- a/app/ui/main_window.py
+++ b/app/ui/main_window.py
@@ -32,13 +32,24 @@ AI(Anthropic Claude)へ送り、部屋名だけをJSONで受け取る。送
 対応を書いたYAML(`app/config/mapping.example.yaml` を参考に作る)を選ぶと、
 `app/core/mapping.py` が選んだExcelテンプレートに合う設定を探し、その設定の
 シート・欄へ書き込む。設定ファイルを選ばなければ第7回と同じ既定の動作になる。
+第9回では、次の2つを追加した。
+- 「7. フォルダ内のPDFをまとめて処理する」ボタン(`app/ui/batch_dialog.py`)
+- 時間のかかる読み取り(ローカルOCR・外部AI)を別スレッドで実行する仕組み
+  (`app/core/background.py`)。これまでは読み取りの間、画面が固まっていた。
+  いまはPyMuPDFでの画像化(短時間)だけをこの画面のスレッドで行い、OCR・外部AIの
+  呼び出しを別スレッドへ渡す。処理中は進捗バーを動かし、「中止」を押せる。
+  画面(ウィジェット)の更新は、結果が戻ってきたあとにこの画面のスレッドでだけ行う。
 """

 from __future__ import annotations

 import tkinter as tk
+from collections.abc import Callable
 from pathlib import Path
 from tkinter import filedialog, messagebox, ttk
+from typing import Any
+
+from app.core.background import BackgroundJob

 from app.core.excel_writer import (
     CellNotEmptyError,
@@ -60,22 +71,23 @@ from app.core.mapping import (
 from app.core.ocr_ai import (
     SEND_CONFIRMATION_TITLE,
     AiOcrError,
-    ai_ocr_pdf_page,
+    ai_ocr_rendered_page,
     build_send_confirmation_message,
     create_client,
     get_api_key,
     resolve_model,
 )
-from app.core.ocr_local import OcrError, is_tesseract_available, ocr_pdf_page
-from app.core.pdf_loader import PdfLoadError
+from app.core.ocr_local import OcrError, is_tesseract_available, ocr_rendered_page
+from app.core.pdf_loader import PdfDocument, PdfLoadError
 from app.core.review_model import ReviewedRoom, ReviewError, ReviewList
 from app.core.room_matcher import RoomCandidate, RoomDictionaryError, filter_room_candidates, load_room_dictionary
 from app.core.text_extractor import ExtractedWord, extract_words
+from app.ui.batch_dialog import open_batch_dialog
 from app.ui.preview_canvas import PreviewCanvas
 from app.ui.review_dialog import open_review_dialog

 WINDOW_TITLE = "間取りOCR転記ツール"
-WINDOW_SIZE = "760x880"
+WINDOW_SIZE = "760x980"

 PDF_FILETYPES = [("PDFファイル", "*.pdf")]
 EXCEL_FILETYPES = [("Excelファイル", "*.xlsx *.xlsm")]
@@ -109,6 +121,9 @@ class MainWindow(ttk.Frame):
         self._last_detection: tuple[list[ExtractedWord], list[RoomCandidate], str, int] | None = None
         self.reviewed_rooms: list[ReviewedRoom] | None = None

+        # 別スレッドで実行中の読み取り(第9回)。実行中は読み取り・確認・転記のボタンを押せなくする
+        self._job: BackgroundJob | None = None
+
         # 転記の設定ファイル(第8回)。未選択なら第7回と同じ既定の対応付けで書き込む
         self.mapping_config: MappingConfig | None = None
         self.mapping_path_var = tk.StringVar(value=MAPPING_NOT_SELECTED)
@@ -134,7 +149,7 @@ class MainWindow(ttk.Frame):

     def _build_widgets(self) -> None:
         self.columnconfigure(0, weight=1)
-        self.rowconfigure(12, weight=1)
+        self.rowconfigure(14, weight=1)

         ttk.Label(self, text="1. CAD図面PDFを選択").grid(row=0, column=0, sticky="w")
         ttk.Button(self, text="PDFを選ぶ...", command=self._on_choose_pdf).grid(row=0, column=1, padx=8)
@@ -204,22 +219,41 @@ class MainWindow(ttk.Frame):
         self.run_button = ttk.Button(
             self, text="6. 実行(確認済みの部屋名をExcelへ転記し、別名で保存)", command=self._on_run, state="disabled"
         )
-        self.run_button.grid(row=10, column=0, columnspan=2, sticky="ew", pady=(4, 12))
+        self.run_button.grid(row=10, column=0, columnspan=2, sticky="ew", pady=(4, 4))
+
+        self.batch_button = ttk.Button(
+            self,
+            text="7. フォルダ内のPDFをまとめて処理する(一括処理)...",
+            command=self._on_open_batch,
+            state="disabled",
+        )
+        self.batch_button.grid(row=11, column=0, columnspan=2, sticky="ew", pady=(4, 12))

         ttk.Label(self, textvariable=self.status_var, foreground="#1a6b2a").grid(
-            row=11, column=0, columnspan=2, sticky="w"
+            row=12, column=0, columnspan=2, sticky="w"
         )
+        # 読み取り中の表示(第9回)。どれくらいで終わるか分からないため、左右に往復する表示にする
+        busy_frame = ttk.Frame(self)
+        busy_frame.grid(row=13, column=0, columnspan=2, sticky="ew", pady=(4, 0))
+        self.busy_bar = ttk.Progressbar(busy_frame, mode="indeterminate", length=300)
+        self.busy_bar.pack(side="left")
+        self.cancel_button = ttk.Button(busy_frame, text="中止", command=self._on_cancel_job, state="disabled")
+        self.cancel_button.pack(side="left", padx=(8, 0))

         ttk.Label(self, text="図面プレビュー(赤枠:検出した単語すべて/青枠:部屋名候補)").grid(
-            row=12, column=0, sticky="nw", pady=(12, 0)
+            row=14, column=0, sticky="nw", pady=(12, 0)
         )
         self.preview = PreviewCanvas(self)
-        self.preview.grid(row=12, column=0, columnspan=2, sticky="nsew", pady=(28, 0))
+        self.preview.grid(row=14, column=0, columnspan=2, sticky="nsew", pady=(28, 0))

     def _on_choose_pdf(self) -> None:
         path = filedialog.askopenfilename(title="CAD図面PDFを選択", filetypes=PDF_FILETYPES)
         if not path:
             return
+        self._load_pdf(path)
+
+    def _load_pdf(self, path: str | Path) -> None:
+        """PDFを検証してプレビューに読み込む(一括処理の結果一覧から開くときにも使う)。"""
         try:
             validated = validate_pdf_path(path)
         except FileSelectionError as exc:
@@ -306,64 +340,146 @@ class MainWindow(ttk.Frame):
             self.run_button.configure(state="disabled")

     def _refresh_buttons(self) -> None:
-        """ボタンの有効・無効を今の状態に合わせる。"""
+        """ボタンの有効・無効を今の状態に合わせる(読み取り中はまとめて無効にする)。"""
+        busy = self._job is not None
         has_pdf = self.preview.document is not None
         normal_if = {True: "normal", False: "disabled"}
-        self.detect_text_button.configure(state=normal_if[has_pdf])
-        self.filter_room_button.configure(state=normal_if[has_pdf and self._room_dictionary is not None])
-        self.review_button.configure(state=normal_if[self._last_detection is not None])
-        self._refresh_run_button()
+        self.detect_text_button.configure(state=normal_if[has_pdf and not busy])
+        self.filter_room_button.configure(state=normal_if[has_pdf and not busy and self._room_dictionary is not None])
+        self.review_button.configure(state=normal_if[self._last_detection is not None and not busy])
+        self.batch_button.configure(
+            state=normal_if[self.selected.excel_path is not None and not busy and self._room_dictionary is not None]
+        )
+        if busy:
+            self.run_button.configure(state="disabled")
+        else:
+            self._refresh_run_button()
+
+    # --- 時間のかかる処理を別スレッドで動かす(第9回) -----------------------------------
+
+    def is_busy(self) -> bool:
+        """別スレッドで読み取り中か(スクリーンショット撮影などで完了を待つために使う)。"""
+        return self._job is not None
+
+    def _run_in_background(
+        self,
+        work: Callable[[BackgroundJob], Any],
+        *,
+        message: str,
+        on_done: Callable[[Any], None],
+        error_title: str,
+    ) -> None:
+        """`work` を別スレッドで実行し、終わったら `on_done` をこの画面のスレッドで呼ぶ。
+
+        `work` の中ではtkinterのウィジェットを触らない(引数の値だけで計算して返す)。
+        画面の更新は `on_done`・エラー表示など、この画面のスレッドで呼ばれる関数の中でだけ行う。
+        """
+        self.status_var.set(message)
+        self.busy_bar.start(15)
+        self.cancel_button.configure(state="normal")
+
+        def finish() -> BackgroundJob | None:
+            job, self._job = self._job, None
+            self.busy_bar.stop()
+            self.busy_bar.configure(value=0)  # 止めた位置に表示が残らないよう戻す
+            self.cancel_button.configure(state="disabled")
+            self._refresh_buttons()
+            return job
+
+        def done(result: Any) -> None:
+            job = finish()
+            if job is not None and job.cancelled:
+                self.status_var.set("中止しました(読み取り結果は使いません)。")
+                return
+            on_done(result)

-    def _detect_words_for_current_page(self) -> tuple[list[ExtractedWord], str] | None:
-        """表示中のページの単語を検出する。戻り値は `(単語リスト, 検出方式)`、失敗時は `None`。
+        def error(exc: BaseException) -> None:
+            job = finish()
+            if job is not None and job.cancelled:
+                self.status_var.set("中止しました。")
+                return
+            if isinstance(exc, (AiOcrError, OcrError, PdfLoadError)):
+                messagebox.showerror(error_title, str(exc))
+            else:
+                messagebox.showerror("予期しないエラー", f"{type(exc).__name__}: {exc}")
+            self.status_var.set("読み取りに失敗しました。")
+
+        self._job = BackgroundJob(work, schedule=self.after, on_done=done, on_error=error)
+        self._refresh_buttons()
+        self._job.start()
+
+    def _on_cancel_job(self) -> None:
+        """「中止」ボタン。実行中のOCR・通信は途中で止められないため、終わった時点で結果を捨てる。"""
+        if self._job is None:
+            return
+        self._job.cancel()
+        self.cancel_button.configure(state="disabled")
+        note = "(外部AIへ送信済みの場合、利用料金はかかります)" if self.read_mode_var.get() == READ_MODE_AI else ""
+        self.status_var.set(f"中止しています…処理が終わりしだい結果を捨てます{note}。")
+
+    def _start_detection(self, on_detected: Callable[[list[ExtractedWord], str], None]) -> None:
+        """表示中のページの単語を検出し、終わったら `on_detected(単語リスト, 検出方式)` を呼ぶ。

         読み取り方式が「ローカル」(既定)の場合は、まず埋め込み文字の抽出
-        (第2回。1ミリ秒未満)を試し、1件も無かった場合だけローカルOCR(第4回)に
-        フォールバックする。「外部AI」の場合は第5回の確認ダイアログを出してから
-        外部AIで読み取る。検出方式は "embedded"(埋め込み文字)・"ocr"(ローカルOCR)・
-        "ai"(外部AI)のいずれか。
+        (第2回。1ミリ秒未満)をこの画面のスレッドで試し、1件も無かった場合だけ
+        ローカルOCR(第4回)にフォールバックする。「外部AI」の場合は第5回の
+        確認ダイアログを出してから外部AIで読み取る。
+
+        第9回から、OCRと外部AIの呼び出し(数百ミリ秒〜数十秒)は別スレッドで行う。
+        PyMuPDFは複数スレッドからの利用に対応していないため、ページの画像化だけは
+        この画面のスレッドで済ませ、別スレッドには画像(`RenderedPage`)だけを渡す。
+        検出方式は "embedded"(埋め込み文字)・"ocr"(ローカルOCR)・"ai"(外部AI)のいずれか。
         """
         document = self.preview.document
-        if document is None:
-            return None
+        if document is None or self._job is not None:
+            return
+        page_number = self.preview.page_number
         if self.read_mode_var.get() == READ_MODE_AI:
-            return self._detect_words_with_ai()
+            self._start_ai_detection(document, page_number, on_detected)
+            return

         try:
-            words = extract_words(document, self.preview.page_number)
+            words = extract_words(document, page_number)
         except PdfLoadError as exc:
             messagebox.showerror("文字抽出エラー", str(exc))
-            return None
+            return
         if words:
-            return words, "embedded"
+            on_detected(words, "embedded")
+            return
         if not is_tesseract_available():
             # OCR機能自体が使えない環境(Tesseract本体未インストール)では、
             # 埋め込み文字が無かった場合そのまま「検出0件」として扱う。
-            return [], "embedded"
+            on_detected([], "embedded")
+            return

-        self.status_var.set("埋め込み文字が無いため、OCRで読み取っています...")
-        self.update_idletasks()
         try:
-            ocr_words = ocr_pdf_page(document, self.preview.page_number)
-        except (OcrError, PdfLoadError) as exc:
+            rendered = document.render_page(page_number, zoom=1.0)  # PyMuPDFはこのスレッドで
+        except PdfLoadError as exc:
             messagebox.showerror("OCRエラー", str(exc))
-            return None
-        return ocr_words, "ocr"
+            return
+        self._run_in_background(
+            lambda _job: ocr_rendered_page(rendered),  # OCRだけを別スレッドで
+            message="埋め込み文字が無いため、OCRで読み取っています...",
+            on_done=lambda ocr_words: self._deliver_detection(document, page_number, ocr_words, "ocr", on_detected),
+            error_title="OCRエラー",
+        )

-    def _detect_words_with_ai(self) -> tuple[list[ExtractedWord], str] | None:
-        """表示中のページを外部AIに送り、部屋名を読み取る(第5回)。
+    def _start_ai_detection(
+        self, document: PdfDocument, page_number: int, on_detected: Callable[[list[ExtractedWord], str], None]
+    ) -> None:
+        """表示中のページを外部AIに送り、部屋名を読み取る(第5回。第9回から別スレッドで通信する)。

         1. APIキー(環境変数 `ANTHROPIC_API_KEY`)が無ければ、送信確認より前にエラーを表示して終わる
            (確認ダイアログで「OK」を押させてから失敗させないため)。
         2. 「図面画像を外部サービスへ送信します」という確認ダイアログを毎回出す。
            「キャンセル」なら何も送信せずに終わる。
-        3. 了承された場合だけ、ページを画像化して送信する。
+        3. 了承された場合だけ、画像化(この画面のスレッド)→送信(別スレッド)の順に行う。
         """
         try:
             api_key = get_api_key()
         except AiOcrError as exc:
             messagebox.showerror("外部AIの設定エラー", str(exc))
-            return None
+            return

         model = resolve_model()
         if not messagebox.askokcancel(
@@ -374,21 +490,34 @@ class MainWindow(ttk.Frame):
             default="cancel",  # Enterキーを押しただけで送信されないよう、既定は「キャンセル」
         ):
             self.status_var.set("外部AIへの送信をキャンセルしました(何も送信していません)。")
-            return None
+            return

-        self.status_var.set("外部AIで読み取っています(通信中)...")
-        self.update_idletasks()
         try:
-            result = ai_ocr_pdf_page(
-                self.preview.document,
-                self.preview.page_number,
-                client=self._create_ai_client(api_key),
-                model=model,
-            )
-        except (AiOcrError, PdfLoadError) as exc:
+            rendered = document.render_page(page_number, zoom=1.0)  # PyMuPDFはこのスレッドで
+        except PdfLoadError as exc:
             messagebox.showerror("外部AIエラー", str(exc))
-            return None
-        return result.words, "ai"
+            return
+        client = self._create_ai_client(api_key)
+        self._run_in_background(
+            lambda _job: ai_ocr_rendered_page(rendered, client=client, model=model).words,
+            message="外部AIで読み取っています(通信中)...「中止」で結果を捨てられます",
+            on_done=lambda words: self._deliver_detection(document, page_number, words, "ai", on_detected),
+            error_title="外部AIエラー",
+        )
+
+    def _deliver_detection(
+        self,
+        document: PdfDocument,
+        page_number: int,
+        words: list[ExtractedWord],
+        source: str,
+        on_detected: Callable[[list[ExtractedWord], str], None],
+    ) -> None:
+        """別スレッドの読み取り結果を画面に反映する。読み取り中にPDF・ページが変わっていたら捨てる。"""
+        if self.preview.document is not document or self.preview.page_number != page_number:
+            self.status_var.set("読み取り中に表示中のPDF・ページが変わったため、結果を表示しませんでした。")
+            return
+        on_detected(words, source)

     def _create_ai_client(self, api_key: str) -> object:
         """外部AIのクライアントを作る(スクリーンショット撮影時などに差し替えられるよう分けている)。"""
@@ -400,10 +529,7 @@ class MainWindow(ttk.Frame):
         ページ送り・拡大縮小をした後にこのボタンを押すと、その時点で表示中の
         ページに対して検出をやり直す(ページごとにキャッシュはしていない)。
         """
-        detected = self._detect_words_for_current_page()
-        if detected is None:
-            return
-        self._show_detected_words(*detected)
+        self._start_detection(self._show_detected_words)

     def _show_detected_words(self, words: list[ExtractedWord], source: str) -> None:
         self.preview.show_word_boxes(words)
@@ -431,10 +557,7 @@ class MainWindow(ttk.Frame):
         """
         if self._room_dictionary is None:
             return
-        detected = self._detect_words_for_current_page()
-        if detected is None:
-            return
-        self._show_room_candidates(*detected)
+        self._start_detection(self._show_room_candidates)

     def _show_room_candidates(self, words: list[ExtractedWord], source: str) -> None:
         if self._room_dictionary is None:
@@ -554,6 +677,28 @@ class MainWindow(ttk.Frame):
             messagebox.showerror("Excel転記エラー", str(exc))
             return None

+    def _on_open_batch(self) -> None:
+        """「7.」一括処理の画面を開く(第9回)。テンプレートと転記の設定はこの画面で選んだものを使う。"""
+        template = self.selected.excel_path
+        if template is None or self._room_dictionary is None or self._job is not None:
+            return
+        mapping = self._resolve_mapping(template)
+        if mapping is None:
+            return
+        open_batch_dialog(
+            self,
+            template=template,
+            mapping=mapping,
+            dictionary=self._room_dictionary,
+            on_open_pdf=self._open_pdf_from_batch,
+        )
+
+    def _open_pdf_from_batch(self, path: Path) -> None:
+        """一括処理で「要確認」「失敗」になったPDFを読み込み、1件ずつの確認へつなぐ。"""
+        self._load_pdf(path)
+        if self.preview.document is not None and self.preview.document.path == Path(path):
+            self.status_var.set(f"{Path(path).name} を読み込みました。「4.」→「5.」で確認してから「6.」で転記してください。")
+

 def build_main_window(master: tk.Tk) -> MainWindow:
     """トップレベルウィンドウに `MainWindow` を組み込んで返す。"""
一括処理の確認用に、架空の図面8件(1件は壊れたファイル)を入れたフォルダを作れるようにします。
tools/make_sample_pdf.py に次の変更を加えます(+ が追加、- が削除)。
tools/make_sample_pdf.py の差分(112行)
--- a/tools/make_sample_pdf.py
+++ b/tools/make_sample_pdf.py
@@ -10,13 +10,20 @@ PyMuPDF自身で描画しただけのテスト用PDF。日本語は組み込みC
 した(`--scanned` オプション)。ローカルOCR(`app/core/ocr_local.py`)の
 動作確認・スクリーンショット撮影用。

+第9回からは、一括処理の動作確認用に「架空の物件の図面PDFを何件か入れたフォルダ」を
+作れるようにした(`--batch`)。埋め込み文字の図面・スキャン図面(150dpi・72dpi相当)・
+部屋名の無い図面・同じ部屋名が2つある図面・部屋数が多すぎる図面・壊れたファイルを含む。
+
 使い方:
     python3 make_sample_pdf.py <出力先.pdf>
     python3 make_sample_pdf.py --scanned [--dpi 150] <出力先.pdf>
+    python3 make_sample_pdf.py --batch <出力先フォルダ>
 """

 from __future__ import annotations

+from pathlib import Path
+
 import fitz

 JAPANESE_FONT = "japan"
@@ -72,14 +79,87 @@ def build_scanned_sample_pdf(path: str, *, dpi: int = 150) -> None:
     out.close()


+#: 部屋名を置く位置(1ページ最大6部屋。架空の間取りの枠の中)
+_ROOM_POSITIONS = [(100, 130), (320, 130), (100, 230), (320, 230), (100, 340), (320, 340)]
+
+
+def build_plan_pdf(path: str | Path, floors: list[list[str]], *, scanned_dpi: int | None = None) -> None:
+    """階ごとの部屋名のリストから、架空の間取り図PDFを作る(第9回)。
+
+    `floors` の1要素が1ページ(1フロア)。1ページに6部屋まで。`scanned_dpi` を指定すると、
+    埋め込み文字を持たない画像だけのPDF(スキャン図面と同じ状態)にする。
+    """
+    doc = fitz.open()
+    for floor_index, rooms in enumerate(floors, start=1):
+        if len(rooms) > len(_ROOM_POSITIONS):
+            raise ValueError(f"1ページに置ける部屋は{len(_ROOM_POSITIONS)}件までです")
+        page = doc.new_page(width=595, height=842)
+        page.draw_rect(fitz.Rect(72, 72, 500, 500), color=(0, 0, 0), width=1.5)
+        page.draw_line((286, 72), (286, 500), color=(0, 0, 0), width=1)
+        page.draw_line((72, 300), (500, 300), color=(0, 0, 0), width=1)
+        page.insert_text((72, 40), f"架空サンプル図面 {floor_index}階", fontsize=10, fontname=JAPANESE_FONT)
+        page.insert_text((100, 160), "W=3640", fontsize=8)
+        for (x, y), name in zip(_ROOM_POSITIONS, rooms, strict=False):
+            page.insert_text((x, y), name, fontsize=16, fontname=JAPANESE_FONT)
+    if scanned_dpi is not None:
+        scanned = fitz.open()
+        for src_page in doc:
+            matrix = fitz.Matrix(scanned_dpi / 72, scanned_dpi / 72)
+            pixmap = src_page.get_pixmap(matrix=matrix, colorspace=fitz.csGRAY)
+            new_page = scanned.new_page(width=src_page.rect.width, height=src_page.rect.height)
+            new_page.insert_image(new_page.rect, pixmap=pixmap)
+        doc.close()
+        doc = scanned
+    doc.save(str(path))
+    doc.close()
+
+
+#: `--batch` で作るフォルダの中身(ファイル名 → (階ごとの部屋名, スキャン解像度))。すべて架空
+BATCH_SAMPLES: dict[str, tuple[list[list[str]], int | None]] = {
+    "サンプルA邸_間取り.pdf": ([["居間", "寝室1", "キッチン", "洗面所"], ["寝室2", "洋室3", "バルコニー"]], None),
+    "サンプルB邸_間取り.pdf": ([["居間", "ダイニング", "キッチン", "浴室", "トイレ", "玄関"]], None),
+    "サンプルC邸_スキャン.pdf": ([["居間", "寝室1", "キッチン", "洗面所"]], 150),
+    "サンプルD邸_粗いスキャン.pdf": ([["居間", "寝室1", "キッチン", "洗面所"], ["寝室2", "洋室3", "バルコニー"]], 72),
+    "サンプルE邸_部屋名なし.pdf": ([[]], None),
+    "サンプルF邸_トイレ2か所.pdf": ([["居間", "キッチン", "トイレ"], ["寝室1", "寝室2", "トイレ"]], None),
+    "サンプルG邸_部屋数が多い.pdf": (
+        [["居間", "ダイニング", "キッチン", "浴室", "洗面所", "玄関"], ["寝室1", "寝室2", "洋室3", "和室", "納戸", "廊下"]],
+        None,
+    ),
+}
+
+#: 壊れたPDFとして置くファイル名(中身はPDFではないバイト列)
+BROKEN_SAMPLE_NAME = "サンプルH邸_壊れたファイル.pdf"
+
+
+def build_batch_sample_folder(folder: str | Path) -> list[Path]:
+    """一括処理の動作確認用フォルダを作り、作ったファイルの一覧を返す(第9回)。"""
+    directory = Path(folder)
+    directory.mkdir(parents=True, exist_ok=True)
+    created: list[Path] = []
+    for name, (floors, scanned_dpi) in BATCH_SAMPLES.items():
+        path = directory / name
+        build_plan_pdf(path, floors, scanned_dpi=scanned_dpi)
+        created.append(path)
+    broken = directory / BROKEN_SAMPLE_NAME
+    broken.write_bytes(b"%PDF-1.7\n% this is not a real pdf (truncated sample)\n")
+    created.append(broken)
+    return created
+
+
 if __name__ == "__main__":
     import argparse

     parser = argparse.ArgumentParser(description="架空サンプル間取りPDFを生成する")
-    parser.add_argument("output", help="出力先のPDFパス")
+    parser.add_argument("output", help="出力先のPDFパス(--batch のときはフォルダ)")
+    parser.add_argument("--batch", action="store_true", help="一括処理の確認用フォルダを作る(第9回)")
     parser.add_argument("--scanned", action="store_true", help="埋め込み文字の無い画像だけのPDFとして作る")
     parser.add_argument("--dpi", type=int, default=150, help="--scanned時の画像化解像度(既定150)")
     args = parser.parse_args()
+    if args.batch:
+        for created in build_batch_sample_folder(args.output):
+            print(f"作成しました: {created}")
+        raise SystemExit(0)
     if args.scanned:
         build_scanned_sample_pdf(args.output, dpi=args.dpi)
     else:
.gitignore に次の変更を加えます(+ が追加、- が削除)。
--- a/.gitignore
+++ b/.gitignore
@@ -26,3 +26,7 @@ output/
 .DS_Store
 .idea/
 .vscode/
+
+# 第9回:一括処理の出力フォルダ・ログ(顧客の図面由来のファイル名を含みうる)
+転記結果_*/
+batch_log.txt
一括処理と別スレッドの仕組みのテストです。
tests/test_batch.py を新しく作ります(全文)。
tests/test_batch.py の全文(498行)
# tests/test_batch.py
"""`app.core.batch` のテスト(tkinter非依存)。

架空の図面PDFを何件か入れたフォルダ(1件は壊れたファイル)を一時フォルダに作り、
次のことを確かめる。

- 1件が壊れていても・想定外の例外が起きても、残りのPDFは最後まで処理される
- 結果が「成功/要確認/失敗」に分かれ、理由が付く
- 「成功」だけExcelへ転記され、「要確認」「失敗」はExcelを作らない
- ログファイルに部屋名(図面の中身)・例外のメッセージ本文・APIキーが書かれない
- 出力ファイル名・出力フォルダ名がぶつからない
- 中止の合図で残りが「未処理」になる

実際のOCR(Tesseract)を使うテストは、本体と日本語学習データが無い環境ではスキップする。
それ以外はOCRの関数をダミーに差し替えて、判定のロジックだけを検証する。
"""

from __future__ import annotations

import shutil
import sys
import threading
from datetime import datetime
from pathlib import Path

import pytest
from openpyxl import load_workbook

from app.core.batch import (
    LOG_FILE_NAME,
    REASON_CANCELLED,
    REASON_CELL_NOT_EMPTY,
    REASON_DUPLICATE,
    REASON_LOW_CONFIDENCE,
    REASON_MAPPING,
    REASON_MAPPING_SKIPPED,
    REASON_NO_CANDIDATES,
    REASON_OCR_UNAVAILABLE,
    REASON_OCR_USED,
    REASON_PDF_OPEN,
    REASON_TOO_MANY_PAGES,
    STATUS_CANCELLED,
    STATUS_FAILED,
    STATUS_REVIEW,
    STATUS_SUCCESS,
    BatchError,
    BatchOptions,
    BatchProgress,
    BatchSummary,
    FileResult,
    describe_summary,
    list_pdf_files,
    make_output_dir,
    run_batch,
    unique_output_path,
)
from app.core.mapping import DEFAULT_MAPPING, FixedLayout, FixedSlot, TemplateMapping, parse_mapping_config
from app.core.ocr_local import is_ocr_language_available
from app.core.pdf_loader import RenderedPage
from app.core.room_matcher import RoomDictionary, load_room_dictionary
from app.core.text_extractor import ExtractedWord

sys.path.insert(0, str(Path(__file__).resolve().parents[1] / "tools"))
from make_sample_pdf import BATCH_SAMPLES, BROKEN_SAMPLE_NAME, build_batch_sample_folder, build_plan_pdf  # noqa: E402

SAMPLE_TEMPLATE = Path(__file__).resolve().parents[1] / "samples" / "room_list_template.xlsx"
FIXED_TIME = datetime(2026, 2, 17, 10, 0, 0)

#: 実際のOCRを伴うテストを実行できるか
_OCR_READY = is_ocr_language_available("jpn")


@pytest.fixture(scope="module")
def dictionary() -> RoomDictionary:
    return load_room_dictionary()


@pytest.fixture
def template(tmp_path: Path) -> Path:
    copied = tmp_path / "template" / "room_list_template.xlsx"
    copied.parent.mkdir()
    shutil.copy(SAMPLE_TEMPLATE, copied)
    return copied


@pytest.fixture
def out_dir(tmp_path: Path) -> Path:
    return make_output_dir(tmp_path / "out", now=FIXED_TIME)


def _no_ocr(_rendered: RenderedPage) -> list[ExtractedWord]:
    raise AssertionError("埋め込み文字のあるPDFでOCRが呼ばれた")


def _fake_ocr(words: list[tuple[str, float]]):
    """画像化済みページを受け取り、決まった単語(信頼度付き)を返すダミーのOCR。"""

    def ocr(rendered: RenderedPage) -> list[ExtractedWord]:
        return [
            ExtractedWord(
                text=text,
                bbox=(100.0, 100.0 + i * 40, 160.0, 116.0 + i * 40),
                font_size=16.0,
                page_number=rendered.page_number,
                confidence=confidence,
            )
            for i, (text, confidence) in enumerate(words)
        ]

    return ocr


def _run(folder: Path, template: Path, out_dir: Path, dictionary: RoomDictionary, **kwargs) -> BatchSummary:
    kwargs.setdefault("mapping", DEFAULT_MAPPING)
    kwargs.setdefault("clock", lambda: FIXED_TIME)
    return run_batch(
        list_pdf_files(folder), template=template, dictionary=dictionary, output_dir=out_dir, **kwargs
    )


def _by_name(summary: BatchSummary) -> dict[str, FileResult]:
    return {r.pdf_path.name: r for r in summary.results}


def _codes(result: FileResult) -> set[str]:
    return {reason.code for reason in result.reasons}


# --- 対象ファイルの列挙 -------------------------------------------------------------


def test_list_pdf_files_only_direct_pdfs_sorted(tmp_path: Path) -> None:
    for name in ["b.pdf", "A.PDF", "c.txt", "~$tmp.pdf", ".hidden.pdf"]:
        (tmp_path / name).write_bytes(b"x")
    (tmp_path / "sub").mkdir()
    (tmp_path / "sub" / "d.pdf").write_bytes(b"x")
    (tmp_path / "folder.pdf").mkdir()  # 拡張子が.pdfのフォルダは対象外

    assert [p.name for p in list_pdf_files(tmp_path)] == ["A.PDF", "b.pdf"]


def test_list_pdf_files_missing_folder(tmp_path: Path) -> None:
    with pytest.raises(BatchError, match="フォルダが見つかりません"):
        list_pdf_files(tmp_path / "nothing")


def test_list_pdf_files_empty_folder(tmp_path: Path) -> None:
    assert list_pdf_files(tmp_path) == []


# --- サンプルフォルダ全体(1件は壊れたファイル) ------------------------------------------


@pytest.mark.skipif(not _OCR_READY, reason="Tesseract本体または日本語学習データが無いため実際のOCRを使うテストをスキップ")
def test_sample_folder_continues_after_broken_file(
    tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary
) -> None:
    folder = tmp_path / "pdfs"
    build_batch_sample_folder(folder)
    progress: list[BatchProgress] = []

    summary = _run(folder, template, out_dir, dictionary, on_progress=progress.append)

    results = _by_name(summary)
    assert len(summary.results) == len(BATCH_SAMPLES) + 1
    assert summary.counts == {STATUS_SUCCESS: 2, STATUS_REVIEW: 5, STATUS_FAILED: 1, STATUS_CANCELLED: 0}
    assert results["サンプルA邸_間取り.pdf"].status == STATUS_SUCCESS
    assert results["サンプルB邸_間取り.pdf"].status == STATUS_SUCCESS
    assert _codes(results["サンプルC邸_スキャン.pdf"]) == {REASON_OCR_USED}
    assert REASON_OCR_USED in _codes(results["サンプルD邸_粗いスキャン.pdf"])
    assert _codes(results["サンプルE邸_部屋名なし.pdf"]) == {REASON_NO_CANDIDATES}
    assert _codes(results["サンプルF邸_トイレ2か所.pdf"]) == {REASON_DUPLICATE}
    assert _codes(results["サンプルG邸_部屋数が多い.pdf"]) == {REASON_MAPPING}
    broken = results[BROKEN_SAMPLE_NAME]
    assert broken.status == STATUS_FAILED
    assert _codes(broken) == {REASON_PDF_OPEN}
    assert "PDFとして開けませんでした" in broken.reason_text

    # 開始・終了で2回ずつ、順番どおりに途中経過が届く
    assert [(p.index, p.result is None) for p in progress] == [
        (i, first) for i in range(1, len(summary.results) + 1) for first in (True, False)
    ]


def test_success_is_written_and_others_are_not(
    tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary
) -> None:
    folder = tmp_path / "pdfs"
    folder.mkdir()
    # 名前順で壊れたファイルが先頭に来るようにし、後ろのPDFが止まらずに処理されることを確かめる
    (folder / "0_broken.pdf").write_bytes(b"%PDF-1.7\nbroken")
    build_plan_pdf(folder / "1_ok.pdf", [["居間", "寝室1"], ["キッチン"]])
    build_plan_pdf(folder / "2_dup.pdf", [["トイレ"], ["トイレ"]])

    summary = _run(folder, template, out_dir, dictionary, ocr_func=_no_ocr)

    results = _by_name(summary)
    assert [r.status for r in summary.results] == [STATUS_FAILED, STATUS_SUCCESS, STATUS_REVIEW]
    ok = results["1_ok.pdf"]
    assert ok.output_path == out_dir / "1_ok_転記.xlsx"
    assert ok.rooms == ("居間", "寝室1", "キッチン")
    assert ok.sources == ("embedded",)
    workbook = load_workbook(ok.output_path)
    sheet = workbook["部屋一覧"]
    assert [sheet[f"C{row}"].value for row in range(5, 9)] == ["居間", "寝室1", "キッチン", None]
    workbook.close()
    # 要確認・失敗はExcelを作らない(出力フォルダにはOKの1件とログだけ)
    assert sorted(p.name for p in out_dir.iterdir()) == sorted(["1_ok_転記.xlsx", LOG_FILE_NAME])
    assert results["2_dup.pdf"].output_path is None
    # 元のテンプレートは変わらない
    assert template.read_bytes() == (SAMPLE_TEMPLATE).read_bytes()


def test_write_excel_false_only_judges(tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary) -> None:
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "ok.pdf", [["居間"]])

    summary = _run(folder, template, out_dir, dictionary, options=BatchOptions(write_excel=False), ocr_func=_no_ocr)

    assert summary.results[0].status == STATUS_SUCCESS
    assert summary.results[0].output_path is None
    assert [p.name for p in out_dir.iterdir()] == [LOG_FILE_NAME]


# --- 要確認の判定 -----------------------------------------------------------------


def test_low_ocr_confidence_needs_review(tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary) -> None:
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "scan.pdf", [["居間"]], scanned_dpi=72)
    ocr = _fake_ocr([("居間", 95.0), ("洗面所", 48.0)])

    summary = _run(folder, template, out_dir, dictionary, ocr_func=ocr, options=BatchOptions(ocr_always_review=False))

    result = summary.results[0]
    assert result.status == STATUS_REVIEW
    assert _codes(result) == {REASON_LOW_CONFIDENCE}
    assert "洗面所(48)" in result.reason_text
    assert result.sources == ("ocr",)


def test_high_ocr_confidence_can_pass_when_configured(
    tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary
) -> None:
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "scan.pdf", [["居間"]], scanned_dpi=72)
    ocr = _fake_ocr([("居間", 95.0), ("寝室1", 91.0)])

    lenient = _run(folder, template, out_dir, dictionary, ocr_func=ocr, options=BatchOptions(ocr_always_review=False))
    assert lenient.results[0].status == STATUS_SUCCESS

    # 既定(OCRで読んだものは常に要確認)では、信頼度が高くても要確認になる
    strict = _run(folder, template, make_output_dir(tmp_path / "out2", now=FIXED_TIME), dictionary, ocr_func=ocr)
    assert strict.results[0].status == STATUS_REVIEW
    assert _codes(strict.results[0]) == {REASON_OCR_USED}


def test_without_tesseract_image_pages_need_review(
    tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary
) -> None:
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "scan.pdf", [["居間"]], scanned_dpi=72)

    summary = _run(folder, template, out_dir, dictionary, ocr_func=None)

    assert summary.results[0].status == STATUS_REVIEW
    assert _codes(summary.results[0]) == {REASON_OCR_UNAVAILABLE, REASON_NO_CANDIDATES}


def test_too_many_pages_needs_review(tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary) -> None:
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "many.pdf", [["居間"], ["寝室1"], ["寝室2"]])

    summary = _run(folder, template, out_dir, dictionary, ocr_func=_no_ocr, options=BatchOptions(max_pages=2))

    result = summary.results[0]
    assert result.status == STATUS_REVIEW
    assert _codes(result) == {REASON_TOO_MANY_PAGES}
    assert result.rooms == ("居間", "寝室1")  # 上限までのページだけ読む
    assert result.page_count == 3


def test_fixed_mapping_skip_needs_review(tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary) -> None:
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "plan.pdf", [["居間", "バルコニー"]])
    mapping = TemplateMapping(
        id="fixed",
        name="固定",
        sheet="部屋一覧",
        layout=FixedLayout(slots=(FixedSlot(label="居間", cell="C5"),), on_unmatched="skip"),
    )

    summary = _run(folder, template, out_dir, dictionary, mapping=mapping, ocr_func=_no_ocr)

    assert summary.results[0].status == STATUS_REVIEW
    assert _codes(summary.results[0]) == {REASON_MAPPING_SKIPPED}
    assert "バルコニー" in summary.results[0].reason_text


def test_mapping_from_example_config_is_used(
    tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary
) -> None:
    config = parse_mapping_config(
        "version: 1\n"
        "templates:\n"
        "  - id: list\n"
        "    name: 右へ並べる一覧\n"
        "    sheet: 部屋一覧\n"
        "    layout: sequential\n"
        "    start_cell: C5\n"
        "    direction: right\n"
        "    max_count: 3\n",
        dictionary=dictionary,
    )
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "plan.pdf", [["居間", "寝室1"]])

    summary = _run(folder, template, out_dir, dictionary, mapping=config.templates[0], ocr_func=_no_ocr)

    workbook = load_workbook(summary.results[0].output_path)
    assert [workbook["部屋一覧"][cell].value for cell in ("C5", "D5")] == ["居間", "寝室1"]
    workbook.close()


# --- 失敗の扱い ---------------------------------------------------------------------


def test_unexpected_exception_does_not_stop_others_and_log_hides_message(
    tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary
) -> None:
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "a_scan.pdf", [["居間"]], scanned_dpi=72)
    build_plan_pdf(folder / "b_ok.pdf", [["寝室1"]])

    def crashing_ocr(_rendered: RenderedPage) -> list[ExtractedWord]:
        raise RuntimeError("図面の中身を含むかもしれないメッセージ 居間")

    summary = _run(folder, template, out_dir, dictionary, ocr_func=crashing_ocr)

    results = _by_name(summary)
    assert results["a_scan.pdf"].status == STATUS_FAILED
    assert "RuntimeError" in results["a_scan.pdf"].reason_text  # 画面には種類とメッセージを出す
    assert results["b_ok.pdf"].status == STATUS_SUCCESS
    log = summary.log_path.read_text(encoding="utf-8")
    assert "unexpected:RuntimeError" in log
    assert "図面の中身を含むかもしれないメッセージ" not in log


def test_cell_not_empty_fails_each_file_without_writing(
    tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary
) -> None:
    workbook = load_workbook(template)
    workbook["部屋一覧"]["C5"] = "既存の値"
    workbook.save(template)
    workbook.close()
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "a.pdf", [["居間"]])
    build_plan_pdf(folder / "b.pdf", [["寝室1"]])

    summary = _run(folder, template, out_dir, dictionary, ocr_func=_no_ocr)

    assert [r.status for r in summary.results] == [STATUS_FAILED, STATUS_FAILED]
    assert all(_codes(r) == {REASON_CELL_NOT_EMPTY} for r in summary.results)
    assert [p.name for p in out_dir.iterdir()] == [LOG_FILE_NAME]


def test_missing_template_is_rejected_before_start(tmp_path: Path, out_dir: Path, dictionary: RoomDictionary) -> None:
    with pytest.raises(BatchError, match="テンプレートが見つかりません"):
        run_batch([], template=tmp_path / "none.xlsx", mapping=DEFAULT_MAPPING, dictionary=dictionary, output_dir=out_dir)


# --- ログ ----------------------------------------------------------------------


def test_log_has_no_room_names_or_api_key(
    tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary, monkeypatch: pytest.MonkeyPatch
) -> None:
    fake_key = "sk-ant-dummy-key-for-log-test-0000"
    monkeypatch.setenv("ANTHROPIC_API_KEY", fake_key)
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "ok.pdf", [["居間", "寝室1", "キッチン"]])
    build_plan_pdf(folder / "dup.pdf", [["洗面所"], ["洗面所"]])
    build_plan_pdf(folder / "scan.pdf", [["浴室"]], scanned_dpi=72)
    (folder / "broken.pdf").write_bytes(b"not a pdf")

    summary = _run(folder, template, out_dir, dictionary, ocr_func=_fake_ocr([("浴室", 50.0)]))

    log = summary.log_path.read_text(encoding="utf-8")
    for room in ["居間", "寝室1", "キッチン", "洗面所", "浴室"]:
        assert room not in log
    assert fake_key not in log
    assert "PDFとして開けませんでした" not in log  # 例外のメッセージ本文も書かない
    # 何が起きたかは種類と件数で分かる
    assert "結果=成功" in log and "出力=ok_転記.xlsx" in log
    assert "理由=duplicate(1)" in log
    assert "理由=low_confidence(1),ocr_used" in log
    assert "理由=pdf_open" in log
    assert log.splitlines()[-1].startswith("# 終了 2026-02-17 10:00:00 成功 1 / 要確認 2 / 失敗 1 / 未処理 0")


# --- 中止 --------------------------------------------------------------------------


def test_cancel_marks_remaining_files(tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary) -> None:
    folder = tmp_path / "pdfs"
    folder.mkdir()
    for name in ["a.pdf", "b.pdf", "c.pdf"]:
        build_plan_pdf(folder / name, [["居間"]])
    cancel = threading.Event()

    def on_progress(progress: BatchProgress) -> None:
        if progress.result is not None and progress.index == 1:
            cancel.set()  # 1件目が終わったところで「中止」を押した

    summary = _run(folder, template, out_dir, dictionary, ocr_func=_no_ocr, on_progress=on_progress, cancel_event=cancel)

    assert [r.status for r in summary.results] == [STATUS_SUCCESS, STATUS_CANCELLED, STATUS_CANCELLED]
    assert summary.cancelled
    assert all(_codes(r) == {REASON_CANCELLED} for r in summary.results[1:])
    assert sorted(p.name for p in out_dir.iterdir()) == sorted(["a_転記.xlsx", LOG_FILE_NAME])
    assert "中止しました" in describe_summary(summary)


def test_cancel_between_pages_stops_current_file(
    tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary
) -> None:
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "scan.pdf", [["居間"], ["寝室1"]], scanned_dpi=72)
    cancel = threading.Event()

    def ocr_then_cancel(rendered: RenderedPage) -> list[ExtractedWord]:
        cancel.set()  # 1ページ目のOCR中に「中止」が押された
        return _fake_ocr([("居間", 95.0)])(rendered)

    summary = _run(folder, template, out_dir, dictionary, ocr_func=ocr_then_cancel, cancel_event=cancel)

    assert summary.results[0].status == STATUS_CANCELLED
    assert [p.name for p in out_dir.iterdir()] == [LOG_FILE_NAME]


# --- 出力先の名前 -------------------------------------------------------------------


def test_unique_output_path_avoids_collisions(tmp_path: Path) -> None:
    (tmp_path / "A邸_転記.xlsx").write_bytes(b"existing")
    reserved: set[str] = set()

    first = unique_output_path(tmp_path, Path("in/A邸.pdf"), ".xlsx", reserved)
    second = unique_output_path(tmp_path, Path("in/B.pdf"), ".xlsx", reserved)
    third = unique_output_path(tmp_path, Path("in/b.PDF"), ".xlsx", reserved)  # Windowsでは同じ名前
    fourth = unique_output_path(tmp_path, Path("in/B.pdf"), ".xlsx", reserved)  # 全角のB

    assert first.name == "A邸_転記_2.xlsx"  # 既存のファイルは上書きしない
    assert second.name == "B_転記.xlsx"
    assert third.name == "b_転記_2.xlsx"
    assert fourth.name == "B_転記_3.xlsx"


def test_case_insensitive_duplicate_pdfs_get_separate_outputs(
    tmp_path: Path, template: Path, out_dir: Path, dictionary: RoomDictionary
) -> None:
    folder = tmp_path / "pdfs"
    folder.mkdir()
    build_plan_pdf(folder / "plan.pdf", [["居間"]])
    build_plan_pdf(folder / "PLAN.pdf", [["寝室1"]])

    summary = _run(folder, template, out_dir, dictionary, ocr_func=_no_ocr)

    outputs = [r.output_path.name for r in summary.results if r.output_path]
    assert len(outputs) == 2
    # 後から処理した方に _2 が付き、大文字小文字を無視しても名前がぶつからない
    assert outputs[1].endswith("_転記_2.xlsx")
    assert len({name.casefold() for name in outputs}) == 2


def test_make_output_dir_does_not_reuse_existing(tmp_path: Path) -> None:
    first = make_output_dir(tmp_path, now=FIXED_TIME)
    second = make_output_dir(tmp_path, now=FIXED_TIME)

    assert first.name == "転記結果_20260217-100000"
    assert second.name == "転記結果_20260217-100000_2"
    assert first.is_dir() and second.is_dir()


def test_run_batch_requires_existing_output_dir(tmp_path: Path, template: Path, dictionary: RoomDictionary) -> None:
    with pytest.raises(BatchError, match="出力フォルダが見つかりません"):
        run_batch([], template=template, mapping=DEFAULT_MAPPING, dictionary=dictionary, output_dir=tmp_path / "none")
tests/test_background.py を新しく作ります(全文)。
tests/test_background.py の全文(162行)
# tests/test_background.py
"""`app.core.background` と、PyMuPDFを同時に呼ばないためのロックのテスト(tkinter非依存)。

tkinterの `after()` の代わりに、呼んでほしい関数をリストにためるだけのダミーの
`schedule` を使い、テスト側で「イベントループ」を回す。これで次のことを確かめる。

- 重い処理は別スレッドで動き、結果・途中経過・例外のコールバックはすべて
  `schedule` を回しているスレッド(画面ではメインスレッド)で呼ばれる
- 途中経過は送った順に届く
- 中止の合図が処理側に伝わる
"""

from __future__ import annotations

import threading
import time
from collections.abc import Callable
from pathlib import Path

import fitz
import pytest

from app.core.background import BackgroundJob
from app.core.pdf_loader import PDF_LOCK, PdfDocument


class FakeLoop:
    """tkinterのイベントループの代わり。`after(ms, func)` で登録された関数を順に呼ぶ。"""

    def __init__(self) -> None:
        self.pending: list[Callable[[], None]] = []
        self.ticks = 0

    def after(self, _ms: int, func: Callable[[], None]) -> None:
        self.pending.append(func)

    def run_until(self, done: Callable[[], bool], timeout: float = 5.0) -> None:
        deadline = time.monotonic() + timeout
        while not done():
            if time.monotonic() > deadline:
                raise AssertionError("時間内に終わらなかった")
            if self.pending:
                self.pending.pop(0)()
                self.ticks += 1
            time.sleep(0.005)


def test_result_and_messages_are_delivered_on_loop_thread() -> None:
    loop = FakeLoop()
    main_thread = threading.get_ident()
    seen: dict[str, object] = {}
    messages: list[tuple[int, int]] = []

    def work(job: BackgroundJob) -> str:
        seen["worker_thread"] = threading.get_ident()
        for i in range(3):
            job.post(i)
            time.sleep(0.01)
        return "完了"

    def on_done(result: object) -> None:
        seen["done"] = (result, threading.get_ident())

    job = BackgroundJob(
        work,
        schedule=loop.after,
        on_done=on_done,
        on_error=lambda exc: seen.setdefault("error", exc),
        on_message=lambda m: messages.append((m, threading.get_ident())),
        poll_ms=10,
    )
    job.start()
    loop.run_until(lambda: job.finished)

    assert seen["worker_thread"] != main_thread  # 重い処理は別スレッドで動いた
    assert seen["done"] == ("完了", main_thread)  # 結果はループのスレッドで受け取った
    assert messages == [(0, main_thread), (1, main_thread), (2, main_thread)]
    assert "error" not in seen


def test_exception_is_delivered_to_on_error() -> None:
    loop = FakeLoop()
    errors: list[BaseException] = []

    def work(_job: BackgroundJob) -> None:
        raise ValueError("失敗しました")

    job = BackgroundJob(work, schedule=loop.after, on_done=lambda _r: None, on_error=errors.append, poll_ms=10)
    job.start()
    loop.run_until(lambda: job.finished)

    assert len(errors) == 1 and isinstance(errors[0], ValueError)


def test_loop_keeps_running_while_work_is_busy() -> None:
    """重い処理の最中も、ループ(画面)側は止まらずに回り続ける。"""
    loop = FakeLoop()
    release = threading.Event()

    def work(_job: BackgroundJob) -> str:
        release.wait(timeout=5)
        return "ok"

    job = BackgroundJob(work, schedule=loop.after, on_done=lambda _r: None, on_error=lambda _e: None, poll_ms=10)
    job.start()
    loop.run_until(lambda: loop.ticks >= 5)  # 処理が終わっていなくても、ループは何度も回れる
    assert not job.finished
    release.set()
    loop.run_until(lambda: job.finished)


def test_cancel_sets_event_seen_by_worker() -> None:
    loop = FakeLoop()
    results: list[object] = []

    def work(job: BackgroundJob) -> str:
        for _ in range(500):
            if job.cancelled:
                return "中止を受け取った"
            time.sleep(0.01)
        return "最後まで実行した"

    job = BackgroundJob(work, schedule=loop.after, on_done=results.append, on_error=lambda _e: None, poll_ms=10)
    job.start()
    job.cancel()
    loop.run_until(lambda: job.finished)

    assert results == ["中止を受け取った"]
    assert job.cancel_event.is_set()


def test_start_twice_is_rejected() -> None:
    loop = FakeLoop()
    job = BackgroundJob(lambda _j: None, schedule=loop.after, on_done=lambda _r: None, on_error=lambda _e: None)
    job.start()
    with pytest.raises(RuntimeError):
        job.start()
    loop.run_until(lambda: job.finished)


def test_pdf_calls_wait_while_another_thread_holds_pdf_lock(tmp_path: Path) -> None:
    """別スレッドがPyMuPDFを使っている間(ロック中)は、画像化が待たされる。"""
    path = tmp_path / "a.pdf"
    doc = fitz.open()
    doc.new_page()
    doc.save(path)
    doc.close()

    finished = threading.Event()
    with PdfDocument(path) as document:

        def render() -> None:
            document.render_page(0)
            finished.set()

        with PDF_LOCK:
            thread = threading.Thread(target=render)
            thread.start()
            time.sleep(0.2)
            assert not finished.is_set()  # ロックを持っている間は画像化が始まらない
        thread.join(timeout=5)
    assert finished.is_set()
OCRのテストには、連結した語の信頼度と、画像化済みのページをOCRする ocr_rendered_page() の確認を足します。
tests/test_ocr_local.py に次の変更を加えます(+ が追加、- が削除)。
--- a/tests/test_ocr_local.py
+++ b/tests/test_ocr_local.py
@@ -251,6 +251,8 @@ def test_merged_word_uses_lowest_confidence_and_median_height(monkeypatch: pytes

     words = ocr_image_to_words(Image.new("RGB", (10, 10)))
     assert [w.text for w in words] == ["寝室1"]
+    # 第9回:連結した語の信頼度は、断片のうち最も低い値(91)が ExtractedWord に入る
+    assert words[0].confidence == 91.0
     # 高さは外接矩形(47px)ではなく断片の高さの中央値((30+47)/2=38.5→38)を使う
     assert words[0].font_size == 38.0

@@ -445,3 +447,25 @@ def test_denoise_recovers_room_names_from_noisy_scan(tmp_path: Path) -> None:
     found = {c.word.text for c in filter_room_candidates(words)}

     assert found == _SAMPLE_ROOMS[0]
+
+
+# --- 第9回:画像化とOCRの分離 ------------------------------------------------------
+
+
+def test_ocr_rendered_page_gives_same_result_as_ocr_pdf_page(tmp_path: Path, monkeypatch: pytest.MonkeyPatch) -> None:
+    """画像化済みのページを渡す `ocr_rendered_page()` は、`ocr_pdf_page()` と同じ結果になる。
+
+    画面では画像化(PyMuPDF)をメインスレッドで、OCRだけを別スレッドで行うため、
+    2つに分けても座標変換・ページ番号が変わらないことを確かめる。
+    """
+    from app.core.ocr_local import ocr_rendered_page
+
+    pdf_path = tmp_path / "scan.pdf"
+    _build_image_only_pdf(pdf_path, "居間")
+    _patch_tesseract(monkeypatch, _fake_image_to_data([(5, "居間", 95.0, 208, 250, 67, 33)]))
+    with PdfDocument(pdf_path) as doc:
+        expected = ocr_pdf_page(doc, 0)
+        rendered = doc.render_page(0, zoom=1.0)
+    assert ocr_rendered_page(rendered) == expected
+    assert expected[0].page_number == 0
+    assert expected[0].confidence == 95.0
動かしてみる
pytest
ruff check .
python tools/make_sample_pdf.py --batch sample_batch
python -m app.main
pytest で「297 passed」と表示されれば完了です。アプリでExcelテンプレート(例:samples/room_list_template.xlsx)を選ぶと「7.」が押せるようになります。一括処理の画面で sample_batch フォルダを選んで「開始」すると、フォルダの中に 転記結果_(日時) フォルダができ、成功したPDFの転記結果と batch_log.txt が保存されます。
動作確認の方法
pytest は297件すべて成功しました(第8回までの268件に、一括処理22件・別スレッドの仕組み6件・OCRの信頼度1件を追加。Tesseract 5.3.4+日本語データのある環境)。ruff check . もエラーはありません。
pytest tests/test_batch.py tests/test_background.py
python tools/make_sample_pdf.py --batch sample_batch   # 架空の図面8件(1件は壊れたファイル)
テストでは、壊れたファイルを先頭に置いても・想定外の例外が起きても後ろのPDFが処理されること、「成功」だけExcelが作られ正しい欄に入ること、中止で残りが「未処理」になること、架空のAPIキーを環境変数に入れて実行してもログにキー・部屋名・例外メッセージが出ないことを確かめています。
次は、架空の図面8件のフォルダを処理中の画面と、終了後の結果一覧です(開発環境(Linux)での確認画面です。Windows実機では見た目が異なります)。
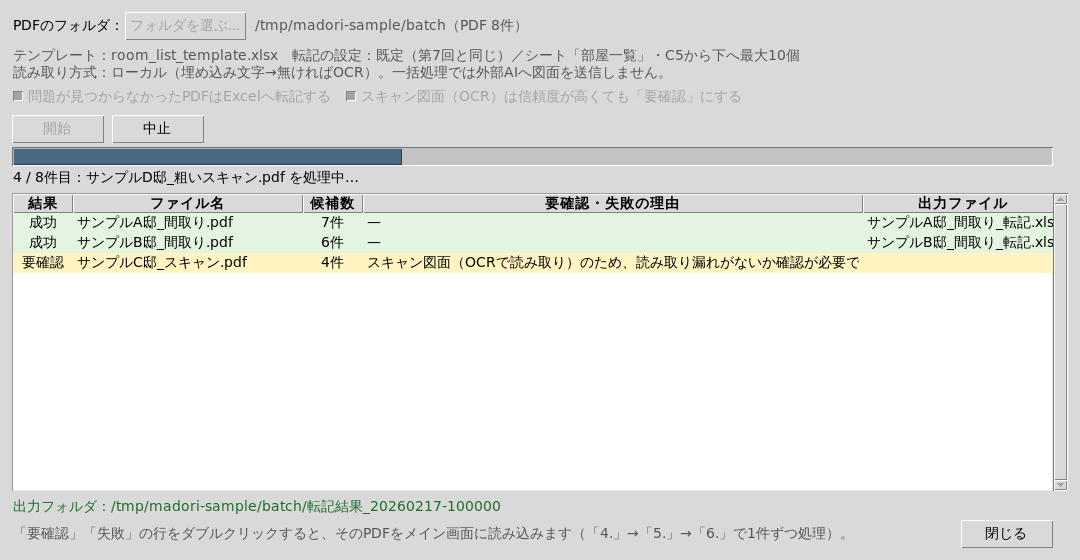
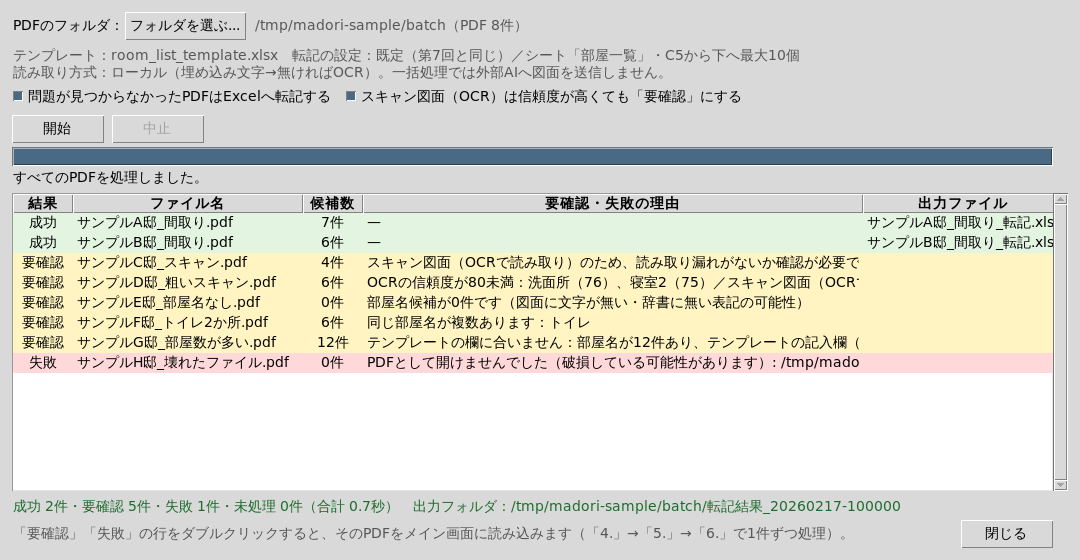
実測した処理時間と「画面が固まらない」ことの確認
Linux開発環境(Intel Xeon 2.1GHz・4vCPU、Tesseract 5.3.4)で、架空の図面を複製した50件のフォルダを2回処理しました。
| 図面の種類 | 件数 | 1件あたり(中央値) |
|---|---|---|
| 埋め込み文字の図面(2ページ、Excel転記まで) | 30件 | 0.011〜0.013秒 |
| スキャン図面 150dpi相当(1ページ、OCR) | 10件 | 0.22〜0.23秒 |
| 粗いスキャン図面 72dpi相当(2ページ、OCR) | 10件 | 0.43〜0.46秒 |
| 合計(全体の時間) | 50件 | 7.0〜7.3秒 |
外部AIは、3秒待ってから応答するダミーで確かめました。第8回までの作りでは画面の更新間隔が最大3.1秒空きました(その間は固まっている)。別スレッドに移した後は、ボタンの処理が十数ミリ秒で戻り、通信中の更新間隔は最大30ミリ秒台でした。
確認できていないこと
- Windows実機での画面・操作感、実際の外部AI(Claude API)での処理時間。外部AIでの一括処理は未実装です
- 実在の図面・大判や多ページの図面・共有フォルダ越しでの処理時間と「要確認」の割合
- PyMuPDFをロックで1スレッドずつ別スレッドから呼ぶ形の長時間の安定性。Linuxの競合試験では異常終了しませんでしたが、公式がサポートする使い方ではないため、Windows実機で長時間試す必要があります
つまずきやすい点・セキュリティ上の注意
- 別スレッドからウィジェットを触らない:途中経過は必ずキューに入れ、メインスレッドで画面を更新します
- PyMuPDFの取り合いで遅くなる:画面側で画像化を連続させながら一括処理を走らせると、50件の処理が7秒台から1〜2分に延びました。処理中は一括処理の画面をモーダル(閉じるまで他を操作できない状態)にしています
- 中止はすぐには効かない:処理中のOCR1ページ・通信1回が終わるまで待ちます
- ログにもファイル名とパスは残る:ファイル名に顧客名・物件名が入るなら、ログも図面と同じ扱いで保管します
発注者向けメモ
「1件ずつ確認」か「まとめて流して結果だけ確認」かで、設計と工数が変わる
「1件ずつ確認」は、処理を止めて人の確認を待つ仕組みと複数ページの確認画面が必要になり、画面まわりの工数が増えます。「まとめて流して結果だけ確認」は、どんな場合に人が見るべきかという判定ルールの決め込みと結果一覧に工数がかかります。
後者の「成功」は人の確認前に転記されたものです。誤転記がどこまで許されるか(後工程で気付けるか、取引先へそのまま出るか)で選ぶべき運用が変わります。迷う場合は、今回のように「問題の無いものだけ自動転記し、残りは1件ずつ確認」から始め、実際の「要確認」の割合を見て判断するのが現実的です。
処理件数・処理時間の見積もりは「図面の種類ごとの1件あたり時間 × 件数」で考える
処理時間は、埋め込み文字の有無で桁が変わります。今回の実測では埋め込み文字の図面が1件0.01秒ほど、スキャン図面が1ページ0.2〜0.25秒ほどでした。ただし架空の簡単な図面での値で、実際の大判・高解像度の図面では長くなります。実際の図面を種類ごとに数件試して1件あたりの時間を測り、件数を掛けるのが確実です。人の確認時間の方がずっと大きくなりやすい点も見込みます。
失敗したときの運用を先に決めておく
壊れたファイルなど、一括処理では何件かの失敗が出る前提で考えます。「失敗したら全体を止める」作りだと、1件のために全体をやり直すことになります。今回は失敗しても次へ進み理由を残す作りですが、失敗・要確認のPDFを誰がいつ処理するか、再実行時に前回の出力とどう突き合わせるかは運用で決める必要があります。
- ☐ 1件ずつ確認か、結果だけ確認かを決めたか
- ☐ 「要確認」にする条件を業務側と合意したか
- ☐ 実際の図面で1件あたりの処理時間を測ったか
- ☐ 失敗・要確認のPDFの担当と再実行の手順、ログの保管場所を決めたか
開発会社への質問例
- 「1件が失敗したとき、残りはどうなりますか?理由はどこで確認できますか?」
- 「人の確認なしで転記されるのは、どんな条件の図面ですか?条件は変えられますか?」
- 「処理中に画面が固まったり、中止できなかったりしませんか?」
- 「ログに図面の内容やAPIキーが残ることはありませんか?」
まとめと次回予告
第9回では、フォルダ内の図面PDFをまとめて処理する app/core/batch.py と、重い処理を別スレッドで動かす app/core/background.py を実装しました。1件が失敗しても残りを続け、「成功/要確認/失敗」と理由の一覧で確認でき、「要確認」は1件ずつの確認画面へ引き継ぎます。外部AIの通信中に画面が固まる問題も解消しました。
次回(第10回)は「ローカル完結モードと外部AIモードを切り替えられるようにする」です。設定画面で読み取り方式を切り替えられるようにし、APIキーをWindowsの資格情報マネージャーへ安全に保存します。
この連載の記事一覧
この記事は連載「CAD図面PDFをExcelへ自動転記するツール開発」の1回です。連載のほかの回は次のとおりです(連載の一覧ページ)。
- 【CAD図面PDFをExcelへ自動転記するツール開発 第0回】要件整理とPython開発環境、tkinterの最初の画面を作る
- 【CAD図面PDFをExcelへ自動転記するツール開発 第1回】PyMuPDFで図面PDFを画面にプレビュー表示する
- 【CAD図面PDFをExcelへ自動転記するツール開発 第2回】PyMuPDFで図面の文字を座標付きで抽出し、プレビューにハイライト表示する
- 【CAD図面PDFをExcelへ自動転記するツール開発 第3回】部屋名辞書とヒューリスティックで「部屋名らしき文字列」だけを絞り込む
- 【CAD図面PDFをExcelへ自動転記するツール開発 第4回】スキャン図面・画像PDFの部屋名をローカルOCR(Tesseract)で読み取る
- 【CAD図面PDFをExcelへ自動転記するツール開発 第5回】外部AI(Claude)の画像解析で図面の部屋名を読み取り、精度を底上げする
- 【CAD図面PDFをExcelへ自動転記するツール開発 第6回】AI・OCRの読み取り結果を人が確認・修正する画面を作る
- 【CAD図面PDFをExcelへ自動転記するツール開発 第7回】確認済みの部屋名を指定のExcelフォーマットの決まった欄へ転記する
- 【CAD図面PDFをExcelへ自動転記するツール開発 第8回】部屋名とExcelの欄の対応付けを設定ファイル(YAML)で変えられるようにする
- 【CAD図面PDFをExcelへ自動転記するツール開発 第9回】複数の図面PDFをフォルダごとまとめて処理する(進捗表示・中止・失敗しても止まらない一括処理)(この記事)
- 【CAD図面PDFをExcelへ自動転記するツール開発 第10回】ローカル完結モードと外部AIモードを切り替え、APIキーをWindowsの資格情報マネージャーに保存する
- 【CAD図面PDFをExcelへ自動転記するツール開発 第11回(最終回)】PyInstallerでWindows向けexeにまとめて配布し、精度の限界と確認のルールを整理する









コメント
コメント一覧 (2件)
[…] 前回(第9回)では、フォルダ内の図面PDFをまとめて処理する一括処理と、重い処理を別スレッドで動かす仕組みを作りました。 […]
[…] 次回(第9回)は「複数のPDF・複数物件をまとめて処理する」です。フォルダを指定して複数の図面PDFを一括で処理し、1件が失敗しても残りを止めない仕組みとログ出力を作ります。 […]